🔍 OLAP 工作室是什么?
OLAP 工作室 是一个专注于 DuckDB 数据库 实战的中文技术博客。我们提供从入门到进阶的 DuckDB 教程,覆盖数据分析、ETL 数据清洗、性能基准测试等场景。所有示例均可实际运行,所有性能结论都附带测试条件。
DuckDB 是一个嵌入式列式数据库,专为 在线分析处理 (OLAP) 设计。在公开的第三方基准中,它在多类分析查询上快于 Pandas 与 SQLite,且不需要像 Snowflake 那样复杂的集群架构。无论是处理 GB 级别的 CSV 文件,还是构建数据管道,DuckDB 都能让你的工作效率大幅提升。
📘
实战教程
从零开始学 DuckDB,涵盖数据分析、ETL、大数据处理等真实业务场景,上手即用
⚡
性能基准
DuckDB vs Pandas/Polars/SQLite 实测对比,用数据说话,帮你做工具选型决策
🧩
进阶技巧
窗口函数、JSON 处理、宏与递归 CTE —— 深入解析并附可运行 SQL
🛠️
最佳实践
生产环境部署、性能优化、常见坑点,让 DuckDB 真正在你的项目中落地
🧭 学习路径
1
入门
安装 DuckDB,直接用 SQL 查询 CSV、Parquet 与 JSON 文件
2
建模
在多 GB 数据集上使用 JOIN、窗口函数、CTE 与聚合
3
调优
读懂 EXPLAIN 计划,调整内存与线程,并与 Pandas 对比基准
4
生产
落地定时管道、Parquet 数据湖与嵌入式分析
🔥 热门推荐
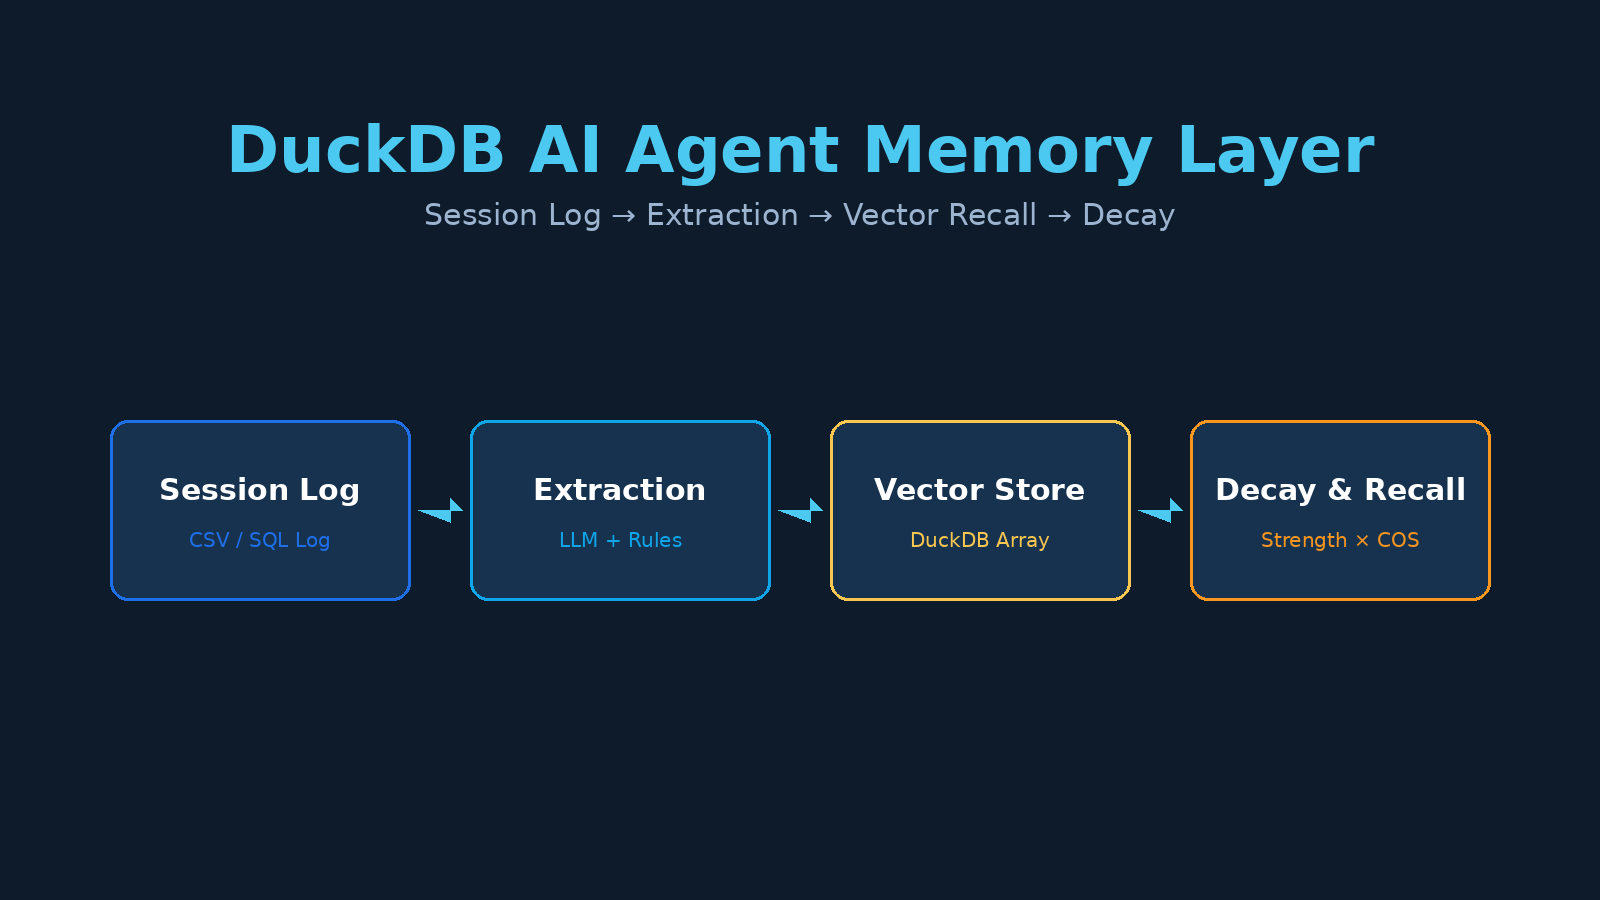
用 DuckDB 构建 AI Agent 的记忆层:会话日志到长期记忆的完整工程实现
用 DuckDB 的内置向量能力构建 AI Agent 记忆层:会话日志抽取、向量召回、记忆衰减与巩固。完整可运行代码,标注 DuckDB 版本,覆盖 2026 年 agent 落地的核心工程问题。
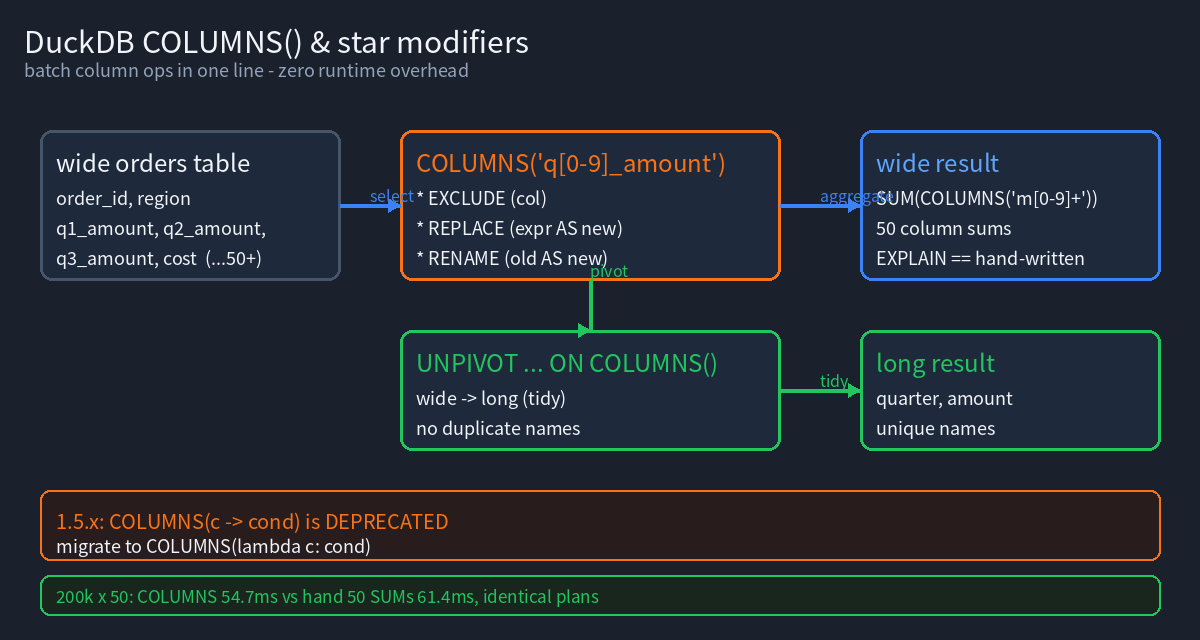
DuckDB COLUMNS() 表达式与星号修饰符:一行 SQL 批量处理多列
DuckDB 的 COLUMNS() 表达式配合星号修饰符(EXCLUDE / REPLACE / RENAME),让你一行 SQL 完成批量列选取、聚合与改名。本文含可复现代码与 20 万行×50 指标的执行计划一致性验证。
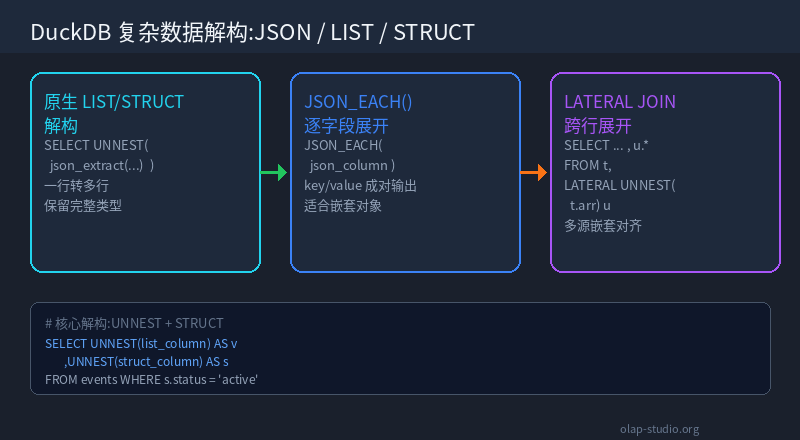
DuckDB 深度实践:用 UNNEST 和 STRUCT 解构复杂 JSON 与数组数据
嵌套的 JSON 和复杂数组是数据分析里最常见的头疼事。本文在 DuckDB 1.5.2 上逐一实测 4 种解构方式(原生 LIST/STRUCT、JSON_EACH、JSON 列表 CAST、LATERAL JOIN),每个示例都附带真实可运行代码与实测输出,并标注了常见写法的报错边界。
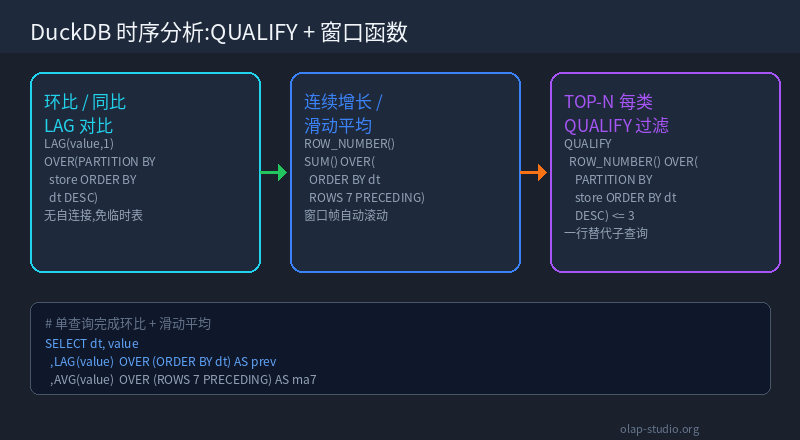
DuckDB 时序分析利器:QUALIFY 与窗口函数实战
还在为复杂的时序数据分析头疼?DuckDB 的 QUALIFY 结合强大的窗口函数,能让你在不写子查询、不建临时表的情况下,轻松完成环比、同比、滑动平均等高级分析,大幅提升查询性能与代码简洁度。本文通过实战案例,深入解析这一组合在实时数据分析中的强大应用。
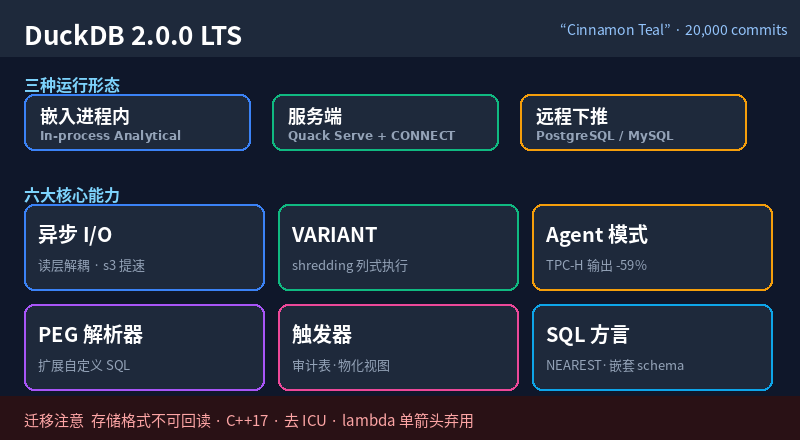
DuckDB 2.0 深度解读:从嵌入式数据库到服务化数据库的质变
DuckDB 2.0 LTS 不只是又一次功能堆叠。它把 Quack 服务化协议、异步 I/O、一等 VARIANT 类型、触发器、PEG 解析器写进核心,重塑了嵌入式数据库的边界。本文逐层拆解 2.0 的架构变化,每个特性都配可运行代码,附破坏性变更迁移清单。
DuckDB 数组聚合实战:ARRAY_AGG + DISTINCT 把明细表压成一行画像,附 EXPLAIN 源码级解析
DuckDB 的 ARRAY_AGG(DISTINCT ...) 一行 SQL 就能把百万行明细压成每个客户一行画像。本文拆解 DISTINCT 修饰符在哈希聚合内部的执行过程(EXPLAIN 实证),并给出 5 个高频画像场景:购买档案、最近活跃窗口、跨品类标记、Top-N 商品、NULL 陷阱,全部代码在 DuckDB v1.5.2 本地跑通。
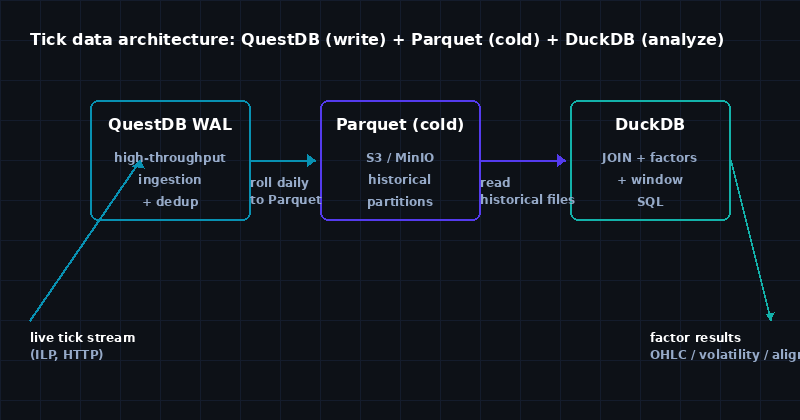
DuckDB 处理 Tick 数据:为什么我用 QuestDB 做写入、DuckDB 做分析
一套实用的 tick 数据架构:QuestDB 负责高吞吐写入 + WAL 去重,DuckDB 负责 JOIN 与因子计算。附三段可复制的 SQL、测试环境与实测结果。
📚 继续深入
读完这些,把 DuckDB 真正用到生产里(安装 → 建模 → 优化 → 部署)
❓ DuckDB 常见问题
DuckDB 适合什么场景?
DuckDB 最适合分析型查询场景:数据探索、ETL 管道、大规模 CSV/Parquet 文件处理、嵌入式 BI 报表。它不适合 OLTP 场景(如高并发事务处理),那是 SQLite/PostgreSQL 的领域。
DuckDB 和 Pandas 哪个快?
在 GB 级数据集的多类分析查询上,DuckDB 通常快于 Pandas,因为它的列式存储和向量化执行引擎在处理大规模数据时具有天然优势。具体倍数高度依赖数据规模、查询形状与硬件配置,本站基准文章均标注了测试环境(本机实测见 性能基准)。
DuckDB 能替代数据仓库吗?
在几十到几百 GB 的单机分析场景下,往往可以——DuckDB 能直接查询 Parquet 和 Iceberg/Delta 文件,无需维护集群。但超出该规模、或需要高并发服务时,分布式数据仓库仍是更合适的选择。
DuckDB 能处理多大数据量?
DuckDB 的单机性能可以轻松处理 10GB-100GB 级别的数据。配合 Parquet 格式和分区技术,也能高效分析 TB 级数据。对于大多数中小企业的数据分析需求,DuckDB 完全够用。