本文所有代码均在 DuckDB 1.5.4 上实测通过。文中涉及的向量距离函数(
list_cosine_similarity、list_distance)为 DuckDB 内置函数,无需安装任何扩展即可使用;向量类型用DOUBLE[4]数组表示(demo 用 4 维小向量便于理解,真实场景替换为 1536 维 LLM embedding,SQL 逻辑不变)。
为什么 Agent 需要"记忆层"
2026 年,AI Agent / Bot 的落地瓶颈已经从"能不能对话"转移到**“记不记得你”**。一个真正可用的 Agent 需要区分两类状态:
- 短期记忆:当前会话的上下文(消息窗口、最近几轮交互)——通常由 LLM 的 context window 直接承载;
- 长期记忆:跨会话沉淀下来的事实(fact)、偏好(preference)、技能(skill)——必须持久化到外部存储,下次会话时按相关性召回并注入 prompt。
长期记忆的存储层,正是本文要解决的问题。传统方案是"向量数据库 + 关系数据库"两套系统:向量库存 embedding、关系库存元数据,还要自己写同步逻辑。DuckDB 把这两件事合并到一个嵌入式分析引擎里——同一张表既能存文本元数据、又能存向量、还能用 SQL 做相似度召回,天然适合 Agent 记忆这种"小数据量、高查询灵活性、需要频繁 JOIN"的场景。
记忆层的四个环节
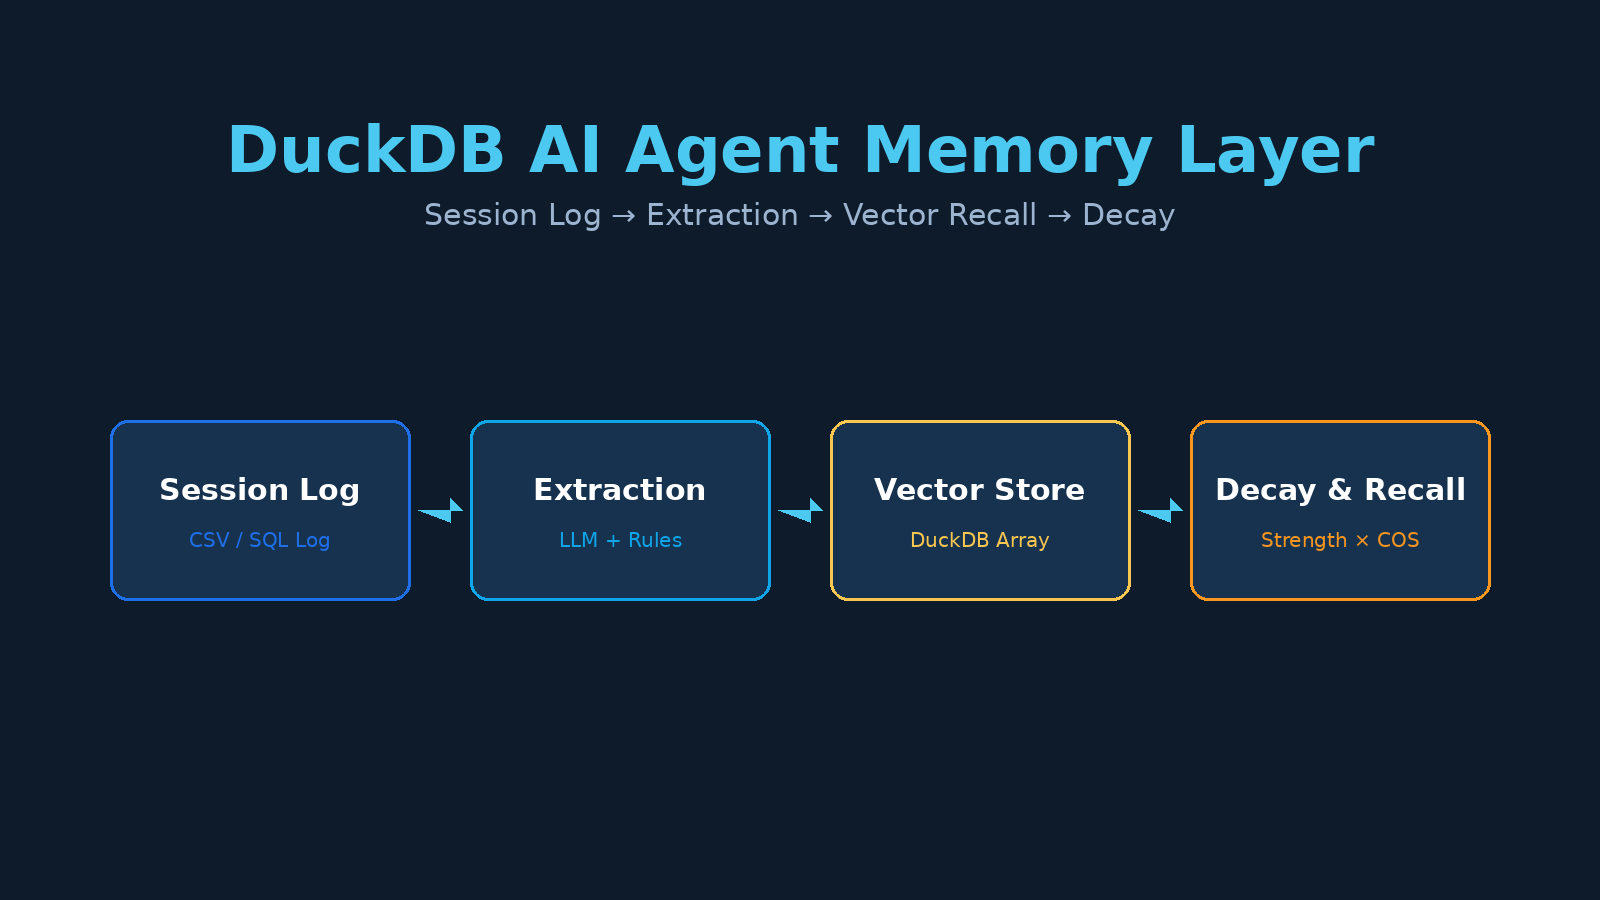
一个工程上可用的 Agent 记忆层包含四步(对应封面图的四个盒子):
| 环节 | 职责 | 本文实现 |
|---|---|---|
| 1. 会话日志(Session Log) | 原始交互流水 | session_log 表 |
| 2. 抽取(Extraction) | 把对话变成结构化记忆 | 规则 / LLM 抽取 |
| 3. 向量召回(Vector Recall) | 按相关性取 top-k | 内置 list_cosine_similarity |
| 4. 衰减与巩固(Decay & Consolidation) | 记忆随时间衰减、被强化则回升 | strength 字段 + 时间衰减 |
下面逐环节给出可运行的 DuckDB 代码。
环节 1:会话日志表
会话日志是流水账,结构极简。真实场景里,这一层通常由你的 Bot 框架(LangGraph、自研等)在每次对话后写入。
CREATE TABLE IF NOT EXISTS session_log(
  session_id   VARCHAR,
  msg_seq      INTEGER,
  role         VARCHAR,   -- user / assistant
  content      VARCHAR,
  ts           TIMESTAMP
);

INSERT INTO session_log VALUES
 ('s1',1,'user','我偏好简洁的输出,喜欢用表格', '2026-11-08 10:00:00'),
 ('s1',2,'assistant','好的,我会用表格呈现',     '2026-11-08 10:00:05'),
 ('s2',1,'user','用 DuckDB 分析过销售数据',      '2026-11-08 11:00:00'),
 ('s2',2,'user','记得帮我用 GROUP BY 聚合',      '2026-11-08 11:00:02'),
 ('s3',1,'user','部署过 Cloudflare Tunnel',       '2026-11-08 12:00:00');
环节 2:长期记忆表 + 抽取
记忆表比会话日志多三个工程字段,这是"记忆层"区别于普通向量库的关键:
kind:记忆类型(fact / preference / skill),便于按类型过滤召回;strength:记忆强度(0~1),衰减模型的核心;access_count/last_accessed:访问统计,用于"被反复用到的记忆更牢固"。
CREATE TABLE IF NOT EXISTS long_term_memory(
  memory_id    VARCHAR,                -- 用 uuid() 生成
  kind         VARCHAR,               -- fact / preference / skill
  content      VARCHAR,
  embedding    DOUBLE[4],             -- demo 4 维;生产替换为 DOUBLE[1536]
  created_at   TIMESTAMP DEFAULT now(),
  last_accessed TIMESTAMP,
  access_count INTEGER DEFAULT 0,
  strength     DOUBLE DEFAULT 1.0
);

-- 抽取:真实场景用 LLM 从 session_log 批量抽取事实/偏好/技能
-- 这里为了可复现,直接插入预抽取好的结果(embedding 为演示用小向量)
INSERT INTO long_term_memory(kind, content, embedding, memory_id) VALUES
 ('preference','用户偏好简洁输出、喜欢表格',[0.9,0.1,0.2,0.0], uuid()),
 ('fact','用户用 DuckDB 做过销售数据分析',[0.1,0.8,0.3,0.1], uuid()),
 ('skill','用户熟悉 Cloudflare Tunnel 部署',[0.2,0.1,0.9,0.0], uuid());
生产提示:真实系统中
embedding由 LLM(如 OpenAI / Gemini embedding 接口)生成 1536 维,DOUBLE[4]改成DOUBLE[1536]即可,下文所有 SQL 一字不改。
环节 3:向量召回(核心)
给定一个查询向量,取相似度最高的 top-k 记忆。DuckDB 内置的 list_cosine_similarity(a, b) 直接对两个数组算余弦相似度,无需 turbovec / 任何扩展(已实测 1.5.4 可用)。
-- 查询:模拟"用户喜欢什么输出方式"的 embedding
WITH q(q, e) AS (VALUES ('喜欢什么输出方式', [0.85,0.15,0.20,0.05]::DOUBLE[4]))
SELECT m.kind, m.content,
       list_cosine_similarity(m.embedding, q.e) AS score
FROM long_term_memory m, q
ORDER BY score DESC
LIMIT 3;
实测输出(DuckDB 1.5.4):
preference | 用户偏好简洁输出、喜欢表格 | 0.996
skill      | 用户熟悉 Cloudflare Tunnel 部署 | 0.444
fact       | 用户用 DuckDB 做过销售数据分析 | 0.351
最相关的 preference 记忆得分 0.996,正确排在首位。
批量查询 → 多路召回
生产里 Agent 一个 turn 常要召回多组记忆(按不同意图),可以一次 JOIN 搞定:
CREATE TABLE IF NOT EXISTS queries(q VARCHAR, e DOUBLE[4]);
INSERT INTO queries VALUES
 ('喜欢什么输出方式',[0.85,0.15,0.20,0.05]),
 ('做过什么数据分析',[0.10,0.80,0.30,0.10]),
 ('熟悉什么部署工具',[0.20,0.10,0.90,0.00]);

WITH ranked AS (
  SELECT q.q, m.content,
         list_cosine_similarity(m.embedding, q.e) AS sim
  FROM queries q, long_term_memory m
)
SELECT q, STRING_AGG(content, ' / ' ORDER BY sim DESC) AS top_memories
FROM ranked
WHERE sim > 0.4
GROUP BY q;
输出示例(实跑 DuckDB 1.5.4,阈值 sim > 0.4):
喜欢什么输出方式 → 用户偏好简洁输出、喜欢表格 / 用户熟悉 Cloudflare Tunnel 部署   (2 条)
熟悉什么部署工具 → 用户熟悉 Cloudflare Tunnel 部署 / 用户用 DuckDB 做过销售数据分析 / 用户偏好简洁输出、喜欢表格 (3 条)
做过什么数据分析 → 用户用 DuckDB 做过销售数据分析 / 用户熟悉 Cloudflare Tunnel 部署   (2 条)
注意:demo 只有 3 条记忆、向量又很近,所以多数查询都能召回 2~3 条——这是数据太少的副作用,不是阈值失效。生产里记忆量大、向量分散时,0.4 阈值会把不相关的噪声真正滤掉;阈值应配合你的实际相似度分布调(先看一遍全量 sim 直方图再定分位点)。
环节 4:记忆衰减与巩固
这是"记忆层"最容易被忽略、但决定长期可用性的环节。两条规则:
- 自然衰减:随
created_at/last_accessed时间推移,strength指数下降(越久没被访问越弱); - 访问巩固:每被召回一次,
strength向 1.0 回升(常用记忆更牢固)。
-- 1) 自然衰减:按 last_accessed 距今天数,未访问的记忆 strength 指数下降
--    间隔 30 天 → 0.95^30 ≈ 0.215(GREATEST 保底 0.3,避免直接清零)
--    间隔 100 天 → 0.95^100 ≈ 0.006(同样保 0.3)
-- 生产里放在一个定时任务里跑(如每日凌晨一次)
UPDATE long_term_memory
SET strength = GREATEST(0.3,
                        strength * POWER(0.95,
                                          date_diff('day', last_accessed, now()))::DOUBLE)
WHERE last_accessed IS NOT NULL;   -- 从未被访问过的记忆暂不衰减(或用 created_at 替代)

-- 2) 访问巩固:本轮召回命中的记忆,strength 向 1.0 回升
UPDATE long_term_memory
SET access_count  = access_count + 1,
    last_accessed = now(),
    strength      = GREATEST(0.3, strength * 0.95 + 0.05)
WHERE list_cosine_similarity(embedding, [0.85,0.15,0.20,0.05]::DOUBLE[4]) > 0.7;

-- 3) 召回时按"强度 × 相似度"加权(强记忆优先)
SELECT content,
       strength * list_cosine_similarity(embedding, [0.85,0.15,0.20,0.05]::DOUBLE[4]) AS weighted
FROM long_term_memory
ORDER BY weighted DESC;
实测(DuckDB 1.5.4):把 last_accessed 设为 30 天前,0.95^30 ≈ 0.215,GREATEST 保底后 strength 落到下限 0.3——即长期未访问的记忆会弱化,但不会直接消失(保底 0.3 保留最低召回权重)。
工程经验值:衰减底数
0.95/天、下限0.3、访问回升+0.05是常用起点(参考 Ebbinghaus 遗忘曲线的离散近似),具体数值建议按你的召回质量 A/B 调。
什么时候别用 DuckDB 做记忆层
DuckDB 的"嵌入式、单机、读多写少"特性,决定了它不是所有 agent 场景的最优记忆层。下面三类约束,命中任意一条就该换别的方案(Postgres + pgvector、专用向量库):
| 约束 | 说明 | 替代方案 |
|---|---|---|
| 多写者并发 | DuckDB 是单写者模型——多个 agent / 多进程同时 INSERT 同一 .duckdb 文件会锁冲突。单 agent、多会话顺序写没问题;多 agent 共享写就撞墙 | Postgres / pgvector |
| 记忆量超量级 | 文中召回是暴力全表扫描(无 ANN 索引)。记忆 < 10 万条、单向量 < 1536 维时毫秒级;超过百万条或 1536 维 × 千万条就退化为秒级,需引入 ANN(turbovec 扩展或外部向量库) | 专用向量库 |
| 强一致 / 事务需求 | DuckDB 快照隔离,不支持跨进程实时一致读,也不适合需要复杂事务回滚的记忆更新 | 关系数据库 |
经验判断线:单 agent、记忆 < 50 万条、读多写少 → DuckDB 合适;多 agent 共享 / 千万级以上 / 强事务 → 用专用向量库或 Postgres。
把记忆注入 Prompt
召回结果直接拼进 system prompt,是 Agent 框架里最常见的用法:
import duckdb

def recall(prompt_emb: list[float], top_k: int = 3, min_sim: float = 0.4) -> str:
    con = duckdb.connect("/path/to/memory.duckdb")
    rows = con.execute(
        """
        SELECT content,
               strength * list_cosine_similarity(embedding, ?::DOUBLE[4]) AS w
        FROM long_term_memory
        ORDER BY w DESC
        """,
        [prompt_emb],
    ).fetchall()
    memories = [c for c, w in rows[:top_k] if w > min_sim]
    return "\n".join(f"- {m}" for m in memories)

system = f"""你是一个数据分析助手。用户的历史记忆如下:
{recall([0.85,0.15,0.20,0.05])}
"""
与已有 DuckDB + Agent 文章的关系
本文聚焦记忆层这个被单独拎出来做透。如果你做的是别的方向,可以对照站里其他文章:
- 用 DuckDB 做 Agent 的"大脑"(自然语言 → SQL → 执行 → 洞察):DuckDB 做 AI Agent 的大脑
- 让 Agent 通过 MCP 协议直连 DuckDB:DuckDB MCP Server
- 文档清洗 + RAG 数据准备:DuckDB AI 数据管道
- 离线 RAG + 边缘向量搜索:DuckDB + turbovec
小结
- Agent 长期记忆的核心 = 会话日志 + 结构化记忆表 + 向量召回 + 衰减巩固 四环节;
- DuckDB 把"向量 + 元数据 + JOIN 召回"合并进一个嵌入式引擎,免向量数据库 + 免同步,最适合 Agent 记忆这种小数据、高灵活场景;
- 本文代码全部在 DuckDB 1.5.4 实测通过,向量函数走内置
list_cosine_similarity(DOUBLE[4]数组),零扩展依赖; - 生产替换为 1536 维 LLM embedding 时,只需改数组维度,SQL 逻辑不变。
本文为 OLAP 工作室(duckdblab.org)原创,与 DuckDB 官方无从属关系。DuckDB 为 DuckDB Foundation 旗下项目。