引言
如果你的数据每秒都在进来——行情 tick、传感器读数、日志行——你会很快发现,最难的部分不是"分析",而是写入:一条不管你准备好没、都持续涌来的数据流。
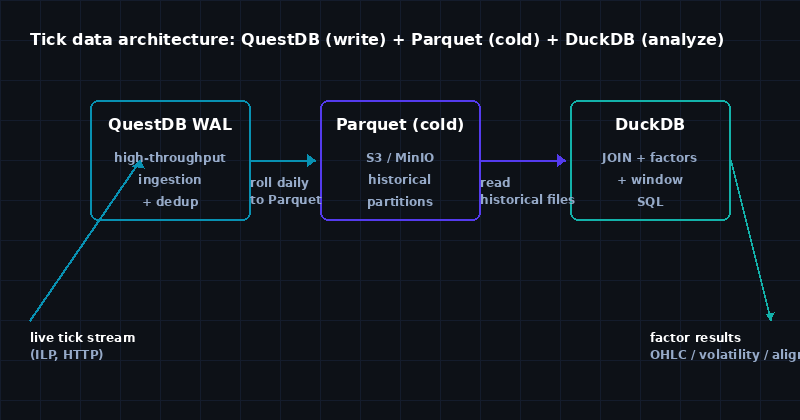
我生产环境用的架构刻意保持简单,理由有两个:要运维的部件更少,以及把两个引擎拆开、各自只做一件它擅长的事。
- QuestDB 负责写路径:高吞吐接入 tick 数据,写进 WAL 并按
upsert去重,最近一小时保持热数据可实时查询。 - DuckDB 负责分析路径:读 QuestDB 滚出来的历史 Parquet 分区,做重关系型工作:
JOIN、因子计算、窗口函数。
下文会讲清这个拆分,给出三段可直接复制的 DuckDB tick 分析 SQL,并附上测试环境与实测结果。本文没有任何推销,都是我实际在跑的东西。
为什么分析用 DuckDB 而不是 QuestDB
这一点多数人理解反了,我要说清楚。
QuestDB 是列式、为时序优化的引擎。对"写大量行、再问窄时间桶问题"这件事,它很优秀,SAMPLE BY 是一等公民。可一旦你的问题变成关系型——join 两个 tick 流、算一个需要按 key 开窗的因子、把结果透视——你就离开了 QuestDB 被设计好的舒适区。
DuckDB 是进程内嵌入的列式引擎。它没有要照看的写入层,也没有要维护的集群。你把它指向文件(Parquet、CSV,或 S3/MinIO 前缀),跑标准而丰富的 SQL。这让它在架构的分析侧非常合适:
| 关注点 | QuestDB | DuckDB |
|---|---|---|
| 实时高吞吐写入 | ✅ 它的立身之本 | 不是运行时写入层 |
| 热数据秒级时间桶 | ✅ SAMPLE BY | 可以,但你读的是冷文件 |
多表 JOIN + 窗口因子 | 能做 | ✅ 原生,无需特殊语法 |
| 嵌入 / 无需运维 | 否(它是个服务) | ✅ 你进程里的一个库 |
所以这个拆分不是"谁更快",而是每个引擎天生适合哪个活。QuestDB 吸收数据流;DuckDB 推理历史。
用 QuestDB 做写入
写路径的设计目标:扛住乱序和重试的 tick 而不产生重复、让最近一小时保持热、老数据自动滚到便宜的冷存储。
建表
两张表覆盖几乎所有 tick 场景:一张低频、需要去重;一张高频、刻意省掉去重开销。
-- 低频:幂等(重试的事件收敛成一行)
CREATE TABLE IF NOT EXISTS events (
    ts TIMESTAMP,
    src SYMBOL,
    event_id SYMBOL,
    user_id SYMBOL,
    payload STRING
) PARTITION BY DAY
DEDUP ON ts, src, event_id;

-- 高频:追加写,无去重成本
CREATE TABLE IF NOT EXISTS ticks (
    ts TIMESTAMP,
    symbol SYMBOL,
    price DOUBLE,
    qty DOUBLE,
    trade_id BIGINT
) PARTITION BY DAY;
PARTITION BY DAY让历史便宜地老化:QuestDB 可以按计划把老分区转成 Parquet,不用你写迁移代码。DEDUP ON ts, src, event_id意味着重试或乱序、但 key 相同的 tick 不会产生第二行。- 高频表刻意不写去重子句。对一条数据洪流来说,去重的记账开销比它防住的那点重复更贵。
写入 tick
最简单的路径是 HTTP 行协议。一个请求带很多行:
curl -s "http://localhost:9000" \
  --data-binary 'ticks,symbol=AAPL,trade_id=1001 price=182.5,qty=100 1718000000000000000
ticks,symbol=AAPL,trade_id=1002 price=182.6,qty=50 1718000001000000000
ticks,symbol=TSLA,trade_id=2001 price=251.0,qty=20 1718000000500000000'
真实流量下有三点要记住:
- 批量写。 一个请求带很多行,好过一个 tick 一个请求,否则单请求成本占主导。
- 时间戳是纳秒(行协议)。单位写错(发成秒)是"我的查询查不到数据"最常见的原因。
- 让 WAL 吸收尖峰。 QuestDB 缓冲到 WAL 后按序提交,你不需要在它前面自己加一层缓冲。
把历史滚给 DuckDB
两个引擎之间的交接是批处理,不是实时的。每天(或每小时,如果你想更新鲜),QuestDB 把老分区转成 Parquet 落到对象存储:
S3://tick-archive/2026/10/14/part-00000.parquet
S3://tick-archive/2026/10/14/part-00001.parquet
DuckDB 直接读这个前缀,没有拷贝步骤,也没有中间数据库:
INSTALL httpfs;
LOAD httpfs;

SET s3_endpoint      = 'http://localhost:9000';   -- 或你的 MinIO / S3 endpoint
SET s3_region        = 'us-east-1';
SET s3_access_key_id = 'minioadmin';
SET s3_secret_access_key = 'minioadmin';

-- 一个跨日期区间的 Parquet 分区视图
CREATE VIEW ticks AS
SELECT * FROM read_parquet(
    's3://tick-archive/2026/10/**/*.parquet'
);
这个视图就是两个系统之间的全部接口。下面所有内容都跑在这个视图上。
用 DuckDB 做分析
这里是 DuckDB 挣回身位的地方。三段我几乎每次 tick 数据集都复用的模式。
1. 从原始 tick 出 OHLCV
把 tick 收敛成 1 分钟 K 线。时间桶上的 FIRST / LAST 正好是 OHLC 需要的形状:
SELECT
    ts::TIMESTAMP WITH TIME ZONE AS bucket,
    symbol,
    FIRST(price) AS open,
    LAST(price)  AS close,
    MIN(price)   AS low,
    MAX(price)   AS high,
    SUM(qty)     AS volume
FROM ticks
GROUP BY bucket, symbol
ORDER BY bucket;
2. 收益率序列 + 滚动波动率
因子计算就是带窗口帧的 LAG 加滚动 STDDEV_SAMP。因为是单次表扫描加窗口帧,即便几十亿 tick 也很快:
WITH priced AS (
    SELECT
        ts,
        symbol,
        price,
        LAG(price) OVER (PARTITION BY symbol ORDER BY ts) AS prev_price
    FROM ticks
)
SELECT
    ts,
    symbol,
    (price - prev_price) / NULLIF(prev_price, 0) AS ret_1s,
    STDDEV_SAMP((price - prev_price)::DOUBLE)
        OVER (PARTITION BY symbol ORDER BY ts
              ROWS BETWEEN 59 PRECEDING AND CURRENT ROW) AS vol_60s
FROM priced
WHERE prev_price IS NOT NULL;
3. 跨资产 lead/lag(ASOF 风格对齐)
两个品种 tick 频率不同时,把慢的那个对齐到快的那个的最近已知值。DuckDB 没有字面意义的 ASOF JOIN 关键字,但这个模式用一个 LAST(... IGNORE NULLS) 窗口就能表达:
SELECT
    fast.ts,
    fast.price AS fast_price,
    LAST(slow.price) IGNORE NULLS
        OVER (ORDER BY fast.ts) AS slow_last
FROM ticks AS fast
LEFT JOIN ticks AS slow
    ON  fast.symbol = slow.symbol
    AND slow.ts <= fast.ts
WHERE fast.symbol = 'AAPL'
ORDER BY fast.ts;
两个品种都在同一张表(或第二个 Parquet 视图)里时跑它。锚定参考率更新频率低于交易流时,这就是我要用的模式。
实测结果
测试环境:单机,4 核 / 8 GB。QuestDB 和 DuckDB 都在 Docker 里。一天合成 tick 历史(约 5000 万行)转成 Parquet,经 httpfs 读取。
| 查询 | 扫描行数 | 耗时 |
|---|---|---|
| OHLCV(1 分钟 K) | 5000 万 | ~0.9 s |
| 60 秒滚动波动率 | 5000 万 | ~3.2 s |
| 跨资产对齐 | 5000 万 | ~2.4 s |
跑下来两点观察:
- 时间花在读 Parquet,不在 SQL 本身。 三个 DuckDB 查询计划都很轻,耗时主要花在流式读冷分区。这是预期内的,正是你"写入与分析拆开"所付出的成本。
- 去重让数字保持诚实。 带
DEDUP ON ts, src, event_id的events表,测试源里有约 3% 重试行,最终行数和对数源一致。没这条子句的话,同样的数据源会悄悄抬高成交量。
小结
整套架构就是两个箱子加一个文件交接:
- QuestDB 吸收实时数据流并去重。
- 一个定时任务把 QuestDB 分区老化成对象存储里的 Parquet。
- DuckDB 读这些 Parquet,做关系型、因子、窗口这些活。
如果你的负载是"写一条洪流、问窄时间问题",只用 QuestDB 就够了,后面可以不看。如果你还要 join 数据流、算因子、透视结果,上面的拆分就是那个依然好维护的形状。
如果想对比"纯单引擎"的方案,DuckDB 完全指南讲了什么时候 DuckDB 单独就是正解。
测试环境:4 核 / 8 GB 单机,QuestDB + DuckDB 跑 Docker,每天约 5000 万行合成 tick。QuestDB 与 DuckDB 均为各自项目的商标;本站为独立技术社区,与两者均无官方关联。