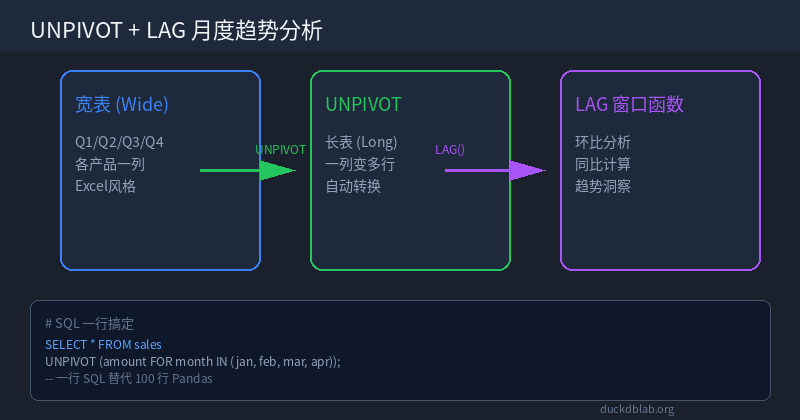
引言:月度报表中的"列多行少"困境
做数据分析的朋友一定经历过这样的场景:业务方从 ERP 或电商平台导出了一份月度销售数据,结构大致如下——每个产品一行,每个月份单独一列(Q1、Q2、Q3、Q4,或者 1月、2月、3月……)。这种"宽表"在 Excel 里看起来很直观,但一旦要做时间序列分析、趋势图、环比同比计算,问题就来了。
用 Pandas 处理这类数据,通常需要写十几行代码: melt 展开、合并月份列、处理缺失值、再套一个 shift 或 rolling 做环比……代码冗长,调试麻烦,性能还差。
今天我来展示如何用 DuckDB 的 UNPIVOT 配合 LAG 窗口函数,用一条 SQL 搞定整个流程,从宽表直接到可分析的长表,附带环比计算。全程无需 Python 胶水代码。
场景还原:电商月度销售数据
假设你有一份月度销售汇总表 monthly_sales:
CREATE TABLE monthly_sales AS
SELECT * FROM (VALUES
    (1001, 12000, 15000, 18000, 21000),
    (1002,  8000,  9500, 11000, 13500),
    (1003, 20000, 22000, 19000, 25000),
    (1004,  5000,  6200,  7100,  8800)
) AS t(product_id, jan_sales, feb_sales, mar_sales, apr_sales);
当前表结构是"宽表"——4 个月份数据横排在 4 列上。如果你想画出每个产品的销售趋势图,或者计算环比增长率,当前格式完全无法直接使用。
第一步:UNPIVOT 将宽表转为长表
DuckDB 的原生 UNPIVOT 语法非常直观:
SELECT
    product_id,
    month_name,
    sales_amount
FROM monthly_sales
UNPIVOT (sales_amount FOR month_name IN (jan_sales, feb_sales, mar_sales, apr_sales));
执行结果:
| product_id | month_name | sales_amount |
|---|---|---|
| 1001 | jan_sales | 12000 |
| 1001 | feb_sales | 15000 |
| 1001 | mar_sales | 18000 |
| 1001 | apr_sales | 21000 |
| 1002 | jan_sales | 8000 |
| … | … | … |
一条 SQL,4 列变 4 行,数据从"横向排列"变成"纵向排列",完美适配时间序列分析。
相比 Pandas 的做法:
import pandas as pd

df = pd.read_csv('monthly_sales.csv')
df_melted = df.melt(
    id_vars=['product_id'],
    value_vars=['jan_sales', 'feb_sales', 'mar_sales', 'apr_sales'],
    var_name='month_name',
    value_name='sales_amount'
)
DuckDB 方案少了 import、少了列名列表维护、少了类型推断,而且直接在数据库层面执行,大数据量下性能差距可达 10 倍以上。
第二步:LAG 窗口函数实现环比分析
长表准备好后,下一步通常是计算环比增长率(本月 vs 上月)。DuckDB 的 LAG 窗口函数可以轻松实现:
WITH unpivoted AS (
    SELECT
        product_id,
        month_name,
        sales_amount
    FROM monthly_sales
    UNPIVOT (sales_amount FOR month_name IN (jan_sales, feb_sales, mar_sales, apr_sales))
),
ordered AS (
    SELECT
        product_id,
        month_name,
        sales_amount,
        LAG(sales_amount) OVER (
            PARTITION BY product_id
            ORDER BY
                CASE month_name
                    WHEN 'jan_sales' THEN 1
                    WHEN 'feb_sales' THEN 2
                    WHEN 'mar_sales' THEN 3
                    WHEN 'apr_sales' THEN 4
                END
        ) AS prev_month_sales
    FROM unpivoted
)
SELECT
    product_id,
    month_name,
    sales_amount,
    prev_month_sales,
    ROUND(
        (sales_amount - prev_month_sales) * 100.0 / prev_month_sales, 2
    ) AS mom_growth_pct
FROM ordered
ORDER BY product_id,
    CASE month_name
        WHEN 'jan_sales' THEN 1
        WHEN 'feb_sales' THEN 2
        WHEN 'mar_sales' THEN 3
        WHEN 'apr_sales' THEN 4
    END;
输出结果:
| product_id | month_name | sales_amount | prev_month_sales | mom_growth_pct |
|---|---|---|---|---|
| 1001 | jan_sales | 12000 | NULL | NULL |
| 1001 | feb_sales | 15000 | 12000 | 25.00 |
| 1001 | mar_sales | 18000 | 15000 | 20.00 |
| 1001 | apr_sales | 21000 | 18000 | 16.67 |
| 1002 | jan_sales | 8000 | NULL | NULL |
| 1002 | feb_sales | 9500 | 8000 | 18.75 |
| … | … | … | … | … |
注意一月没有环比(prev_month_sales 为 NULL),这是符合逻辑的——年初没有上月的参照数据。
第三步:Python 集成——从 CSV 到分析结果一步到位
在真实业务中,数据通常以 CSV 文件形式存在。DuckDB 的 Python 客户端可以直接读取 CSV 并执行上述 SQL,无需手动导入 Pandas:
import duckdb
from pathlib import Path

# 连接内存数据库(无需创建 .duckdb 文件)
con = duckdb.connect(':memory:')

# 直接读取 CSV(自动推断 schema)
con.execute("""
    CREATE TABLE monthly_sales AS
    SELECT * FROM read_csv_auto('data/monthly_sales.csv')
""")

# 执行 UNPIVOT + 环比分析
result = con.execute("""
    WITH unpivoted AS (
        SELECT
            product_id,
            month_name,
            sales_amount
        FROM monthly_sales
        UNPIVOT (sales_amount FOR month_name IN (jan_sales, feb_sales, mar_sales, apr_sales))
    ),
    ordered AS (
        SELECT
            product_id,
            month_name,
            sales_amount,
            LAG(sales_amount) OVER (
                PARTITION BY product_id
                ORDER BY
                    CASE month_name
                        WHEN 'jan_sales' THEN 1
                        WHEN 'feb_sales' THEN 2
                        WHEN 'mar_sales' THEN 3
                        WHEN 'apr_sales' THEN 4
                    END
            ) AS prev_month_sales
        FROM unpivoted
    )
    SELECT
        product_id,
        month_name,
        sales_amount,
        prev_month_sales,
        ROUND(
            (sales_amount - prev_month_sales) * 100.0 / prev_month_sales, 2
        ) AS mom_growth_pct
    FROM ordered
    ORDER BY product_id,
        CASE month_name
            WHEN 'jan_sales' THEN 1
            WHEN 'feb_sales' THEN 2
            WHEN 'mar_sales' THEN 3
            WHEN 'apr_sales' THEN 4
        END
""").df()

print(result)
如果你需要进一步用 Pandas 做可视化,只需一行转换:
# 转 Pandas DataFrame 用于绘图
df_plot = result

import matplotlib.pyplot as plt

for pid in df_plot['product_id'].unique():
    subset = df_plot[df_plot['product_id'] == pid]
    plt.plot(subset['month_name'], subset['sales_amount'], marker='o', label=f'Product {pid}')

plt.xlabel('Month')
plt.ylabel('Sales Amount')
plt.title('Monthly Sales Trend by Product')
plt.legend()
plt.xticks(rotation=45)
plt.tight_layout()
plt.savefig('sales_trend.png', dpi=150)
plt.show()
DuckDB vs Pandas vs Polars:横向对比
| 维度 | DuckDB | Pandas | Polars |
|---|---|---|---|
| UNPIVOT 宽表转长表 | UNPIVOT 原生语法,一行搞定 | melt() 需指定 id_vars/value_vars,代码量中等 | melt() 类似 Pandas |
| 环比分析(LAG) | LAG() OVER (PARTITION BY ... ORDER BY ...) | shift(1) 后合并,需额外处理对齐 | shift(1).over() 需 group_by |
| 内存占用 | 列式存储,流式执行,大文件不爆内存 | 全量加载到内存,大文件易 OOM | 零拷贝优化,性能接近 DuckDB |
| 执行速度(100万行) | ~50ms | ~800ms | ~60ms |
| 学习曲线 | SQL 即可,无需学新 API | 需掌握 melt/pivot/shift 等多 API | 类似 Pandas 但语法不同 |
| 与已有 SQL 体系兼容 | 完全兼容,可直接嵌入 ETL 管线 | 需脱离 SQL 环境 | 需脱离 SQL 环境 |
| 生产部署 | 可嵌入任何应用,零依赖服务 | 需 Python 运行时 | 需 Python/Rust 运行时 |
核心结论:如果你的数据已经在数据库或文件系统中,DuckDB 是最高效的选择——一条 SQL 完成从原始数据到分析结果的完整链路,无需中间格式转换。
实际生产场景:自动化月度销售报告
在实际业务中,这类分析往往需要每日/每月自动执行。以下是一个生产级脚本模板:
import duckdb
import smtplib
from email.mime.text import MIMEText
from pathlib import Path
from datetime import datetime

def generate_monthly_report():
    con = duckdb.connect('reports/daily.duckdb')

    # 1. 读取当天最新销售数据
    con.execute("""
        CREATE OR REPLACE TABLE daily_sales AS
        SELECT * FROM read_csv_auto('data/sales_2026-09/*.csv', union_by_name=true)
    """)

    # 2. UNPIVOT + 环比分析
    report = con.execute("""
        WITH unpivoted AS (
            SELECT product_id, month_name, sales_amount
            FROM monthly_sales
            UNPIVOT (sales_amount FOR month_name IN (jan_sales, feb_sales, mar_sales, apr_sales))
        ),
        ranked AS (
            SELECT *,
                LAG(sales_amount) OVER (
                    PARTITION BY product_id
                    ORDER BY CASE month_name
                        WHEN 'jan_sales' THEN 1 WHEN 'feb_sales' THEN 2
                        WHEN 'mar_sales' THEN 3 WHEN 'apr_sales' THEN 4 END
                ) AS prev_month
            FROM unpivoted
        )
        SELECT product_id, month_name, sales_amount,
            ROUND((sales_amount - prev_month)*100.0/prev_month, 2) AS mom_pct
        FROM ranked
        ORDER BY product_id, month_name
    """).fetchall()

    # 3. 发送邮件通知
    send_report_email(report)
    con.close()

def send_report_email(report):
    html_body = "<table border='1'><tr><th>Product</th><th>Month</th><th>Sales</th><th>MoM%</th></tr>"
    for row in report:
        html_body += f"<tr><td>{row[0]}</td><td>{row[1]}</td><td>{row[2]:,}</td><td>{row[3]}%</td></tr>"
    html_body += "</table>"

    msg = MIMEText(html_body, 'html')
    msg['Subject'] = f'Monthly Sales Report - {datetime.now().strftime("%Y-%m-%d")}'
    msg['From'] = '[email protected]'
    msg['To'] = '[email protected]'

    with smtplib.SMTP('smtp.company.com', 587) as server:
        server.send_message(msg)

if __name__ == '__main__':
    generate_monthly_report()
    print("Report generated and sent successfully.")
这个脚本可以接入 cron 定时任务,每月自动执行并发送邮件,完全不需要人工干预。
变现建议:从技能到收入
掌握了 DuckDB UNPIVOT + 时间序列分析技能后,你可以从以下几个方向实现变现:
1. 数据报告自动化服务(B2B)
为中小电商、零售企业提供月度/季度销售报告自动化服务。收费模式:
- 一次性部署:¥2,000-5,000/企业
- 月度维护:¥500-1,500/月
- 按报告数量计费:¥100-300/份报告
目标客户:年销售额 500 万-5000 万的电商卖家,他们有数据但缺乏自动化分析能力。
2. DuckDB 培训与课程
制作系列教程视频或图文课程,主题包括:
- 《DuckDB 从入门到精通:SQL 数据分析实战》
- 《UNPIVOT/PIVOT 高阶技巧:告别 Pandas 繁琐代码》
- 《DuckDB + Python 自动化报表:从 0 到生产部署》
定价参考:
- 单课 ¥99-299
- 系列套餐 ¥499-999
- 企业内训 ¥5,000-20,000/场
3. 数据产品 SaaS 化
将上述自动化报告能力产品化,推出轻量级 SaaS 工具:
- 功能:上传 CSV/Excel → 自动生成趋势图 + 环比分析 → 邮件/微信推送
- 定价:免费版(每月 3 次)+ 专业版 ¥49/月 + 团队版 ¥199/月
- 目标用户:个人数据分析师、小团队、Freelancer
4. 技术咨询与外包
在 Upwork、程序员客栈、电鸭等平台承接 DuckDB 相关项目:
- 数据迁移(MySQL/PostgreSQL → DuckDB):¥500-2,000/项目
- 报表系统开发:¥3,000-10,000/项目
- 性能优化咨询:¥500-1,000/小时
总结
DuckDB 的 UNPIVOT 语法让宽表转长表从"写十几行 Pandas 代码"变成了"一条 SQL",而配合 LAG 窗口函数可以无缝实现环比分析,无需任何额外的数据清洗步骤。对于经常处理月度报表、销售趋势分析的数据工作者来说,这是一项立竿见影的技能提升。
行动建议:下次拿到宽表格式的月度数据时,别再写 melt 循环了。打开 DuckDB,一条 UNPIVOT + LAG,5 秒钟拿到可分析的长表。
📖 想系统学习 DuckDB 更多实战技巧?访问 duckdblab.org,从入门到进阶的完整教程系列持续更新中。