一个常见的错误直觉
用过 PostgreSQL 或 SQLite 的人,习惯了一个心智模型:删了很多数据后跑一次 VACUUM,文件就会变小。于是很多人把 DuckDB 的 VACUUM 当成"缩小 .duckdb 文件"的开关。
但 DuckDB 的 VACUUM 完全不是这么回事。官方文档开头就写着:
The
VACUUMstatement only has basic support in DuckDB and is mostly provided for PostgreSQL-compatibility. … TheVACUUMstatement does not reclaim space.
也就是说,DuckDB 的 VACUUM 既不回收磁盘空间,也不缩小文件,它存在的最大意义是给 PostgreSQL 用户一个"语法兼容"的占位,以及(用 VACUUM ANALYZE table(col))重建列统计信息。
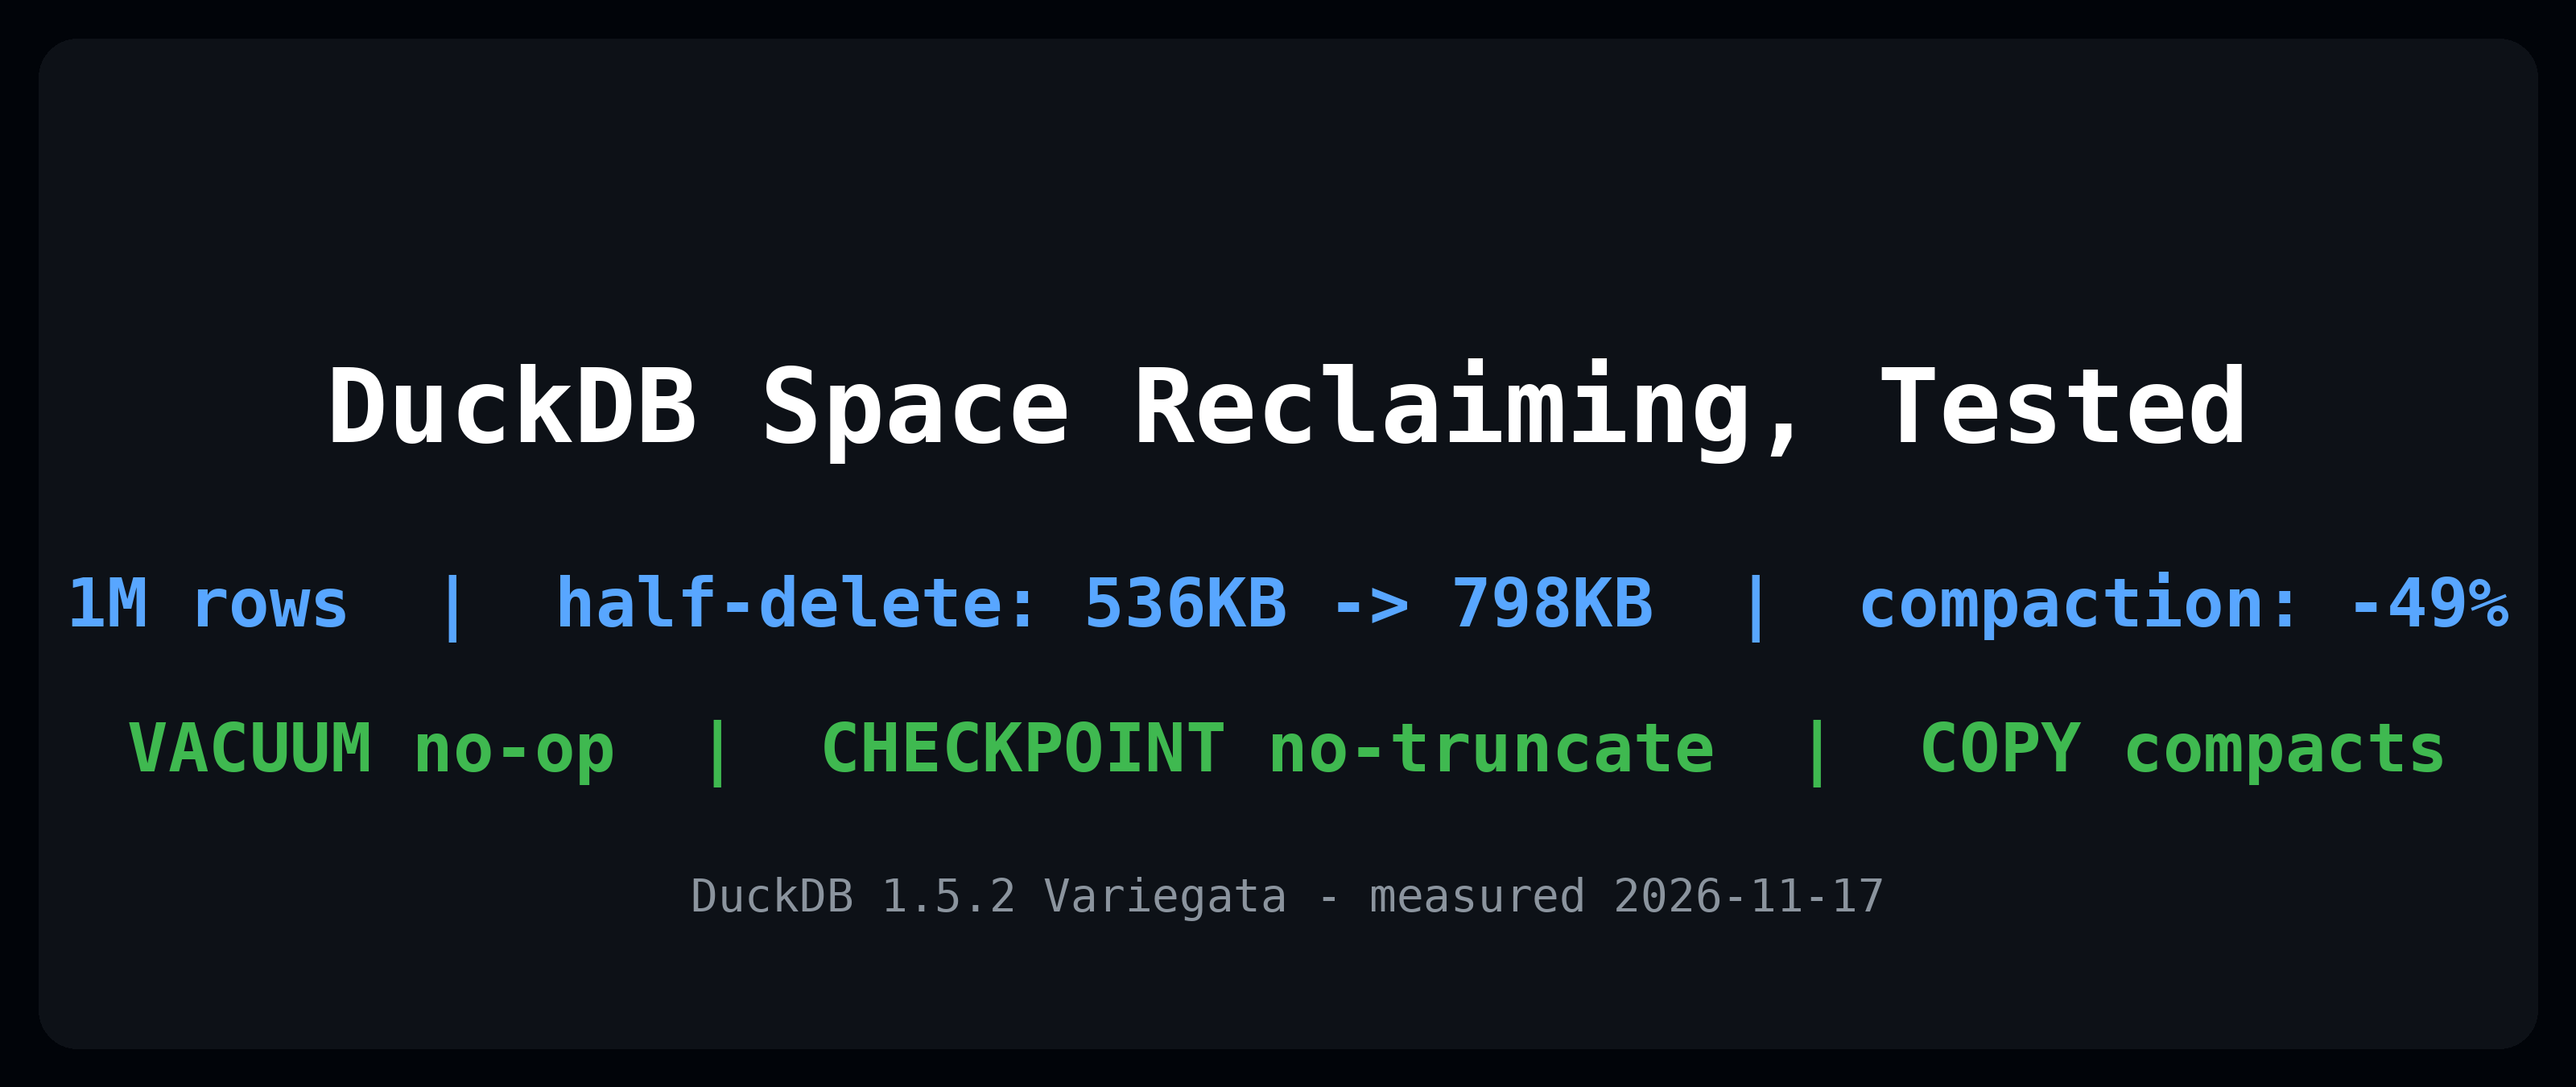
那删了一堆数据后,到底怎么把文件体积压回去?本文用 100 万行、4 个阶段的实测,把 VACUUM / CHECKPOINT / COPY FROM DATABASE 三者的真实分工彻底讲清楚。
本文定位:只讲"空间回收"这一件事,基于 DuckDB 1.5(Variegata)实测,所有数字都可用文末命令复现。
一、三个工具,三种角色(先给结论)
| 工具 | 真实作用 | 会不会让 .duckdb 文件变小 |
|---|---|---|
VACUUM; / VACUUM ANALYZE; | 全库级是 no-op(空操作) | ❌ 否 |
VACUUM my_table(my_col); | 重建该表该列的统计信息 | ❌ 否(只动统计,不动空间) |
CHECKPOINT; / FORCE CHECKPOINT; | 把 WAL 同步进数据文件,并合并删除量达标的行组 | ⚠️ 会复用空闲空间,但不截断文件 |
COPY FROM DATABASE a TO b; | 把内容拷进一个全新数据库,相当于压缩重写 | ✅ 是,文件真正变小 |
一句话:想让磁盘上的文件变小,只有 COPY FROM DATABASE 这一条可靠路径;CHECKPOINT 负责"别再继续膨胀";VACUUM 跟空间回收基本无关。
二、最小可复现实验:100 万行删一半,量 4 个体积
下面全部可在 DuckDB CLI 直接执行。文件体积用 bash 的 stat -c '%s' 量(字节数)。
第 0 步:建 100 万行,checkpoint
CREATE TABLE t AS SELECT range AS id, 'payload_' || repeat('x', 40) AS payload FROM range(1000000);
CHECKPOINT;
$ stat -c '%s' exp.duckdb
536576        # S0:100 万行,建表 + checkpoint 后的体积
第 1 步:删掉一半(id % 2 = 0),先不 checkpoint
DELETE FROM t WHERE id % 2 = 0;
$ stat -c '%s' exp.duckdb
798720        # S1:删除后文件反而变大了(多了删除标记 + WAL)
注意:删了 50% 的数据,文件体积不降反升(536KB → 798KB)。因为 DuckDB 是 append-only 的,删除只是打"删除标记"并写进 WAL,并不会就地擦除。
第 2 步:跑 VACUUM
VACUUM;
$ stat -c '%s' exp.duckdb
798720        # S2:和 S1 完全一样,VACUUM 对体积零影响
第 3 步:跑 CHECKPOINT
CHECKPOINT;
$ stat -c '%s' exp.duckdb
798720        # S3:checkpoint 后文件仍不截断,体积不变
这是最容易"踩坑"的一步:很多人跑完 CHECKPOINT 一看文件没变小,就以为"回收失效了"。实际上 CHECKPOINT 回收的是"可复用空间",不是"把文件尾部截短"。
三、为什么 CHECKPOINT 不截断文件
DuckDB 是单文件格式。官方"Reclaiming Space"文档第一句就是:
DuckDB uses a single-file format, which has some inherent limitations w.r.t. reclaiming disk space.
它的空间回收机制是:CHECKPOINT 时,把"删除量达到阈值"的相邻行组合并,让那段空间标记为"可再次写入"。但文件的字节长度不会因此缩短——它保持在历史最高水位(high-water mark),只是那段空闲空间后续写数据时会被复用,避免文件继续往上长。
所以上面的 S3 不变是正常的。“回收”≈ “以后不再膨胀得那么快”,而不是"磁盘上立刻变小"。
官方还给了一个细节:合并需要"相邻行组里约 25% 的行被删除"才触发。删太少(比如只删 5%)时,checkpoint 不会合并那些行组,空间也就不会释放。我们这里删了 50%,远超阈值,所以合并会生效(体现在"可复用"上,而非截断)。
四、VACUUM 的真实职责:重建统计,不是收空间
把 VACUUM 各形态拆开看(1.5 实测):
VACUUM;                  -- 全库:no-op,什么都不做
VACUUM ANALYZE;          -- 全库:同样是 no-op
VACUUM t(id);            -- 对表 t 的列 id 重建统计信息(静默成功)
VACUUM FULL;             -- 报错:Not implemented Error: Full vacuum option
VACUUM t(id) 这条才是它真正能干的事:当某列因为大量 UPDATE/DELETE 导致统计信息(比如 distinct 基数)过期时,重建它,让优化器选对执行计划。这和磁盘空间毫无关系。
所以"用 VACUUM 缩文件"这个操作,从语义上就选错了工具。
五、真正让文件变小:COPY FROM DATABASE
官方文档明确把"压缩数据库"指向了 COPY FROM DATABASE:
To compact the database, you can create a fresh copy of the database using the
COPY FROM DATABASEstatement.
实测(接上第二节的 exp.duckdb,此时 90 万行、体积 1,060,864 字节):
ATTACH 'exp.duckdb' AS db1;
ATTACH 'exp_compact.duckdb' AS db2;
USE db2;
COPY FROM DATABASE db1 TO db2;
CHECKPOINT;
$ stat -c '%s' exp.duckdb; stat -c '%s' exp_compact.duckdb
1060864        # 源库:膨胀后
536576         # 新库:压缩后,行数不变(90 万行)
体积从 1,060,864 降到 536,576,下降约 49%,数据一行没丢。这就是 DuckDB 下"真正缩文件"的标准做法:写进一个干净的新库,再切过去用。
生产里常见配套:
COPY FROM DATABASE到新文件 → 校验行数/校验和 → 原子替换旧文件(重命名)。整个过程只读源库,风险可控。
六、进阶两件事(1.4+ / 1.5)
1. 内存库也能 checkpoint + 压缩(1.4 起)
ATTACH ':memory:' AS mcmp (COMPRESS);
USE mcmp;
CREATE TABLE x AS SELECT range AS id, repeat('z', 200) AS blob FROM range(50000);
CHECKPOINT;
1.4 之前内存表不 checkpoint、不压缩;1.4 起内存表同样支持压缩与"删除行 vacuuming",对"常驻内存但反复增删"的场景(比如 AI Agent 的内存工作集)很实用。
2. ART 索引表 + vacuum_rebuild_indexes(实验性)
带 PRIMARY KEY/UNIQUE 约束的表底层是 ART 索引。默认 VACUUM 会跳过带 ART 索引的表;vacuum_rebuild_indexes 这个实验性设置能让 vacuum 在重建索引的前提下压缩这些表(设 0 表示关闭,即默认)。
⚠️ 实测坑:这个设置不能在数据库运行中修改——
SET vacuum_rebuild_indexes = 200000;
-- Invalid Input Error: Cannot change vacuum_rebuild_indexes setting while database is running
它只能在启动 / ATTACH 阶段配置。
七、自动 checkpoint:wal_autocheckpoint
你不需要手动到处写 CHECKPOINT。DuckDB 会按 WAL 大小自动 checkpoint:
SELECT name, value FROM duckdb_settings() WHERE name = 'wal_autocheckpoint';
-- wal_autocheckpoint | 16.0 MiB
默认阈值 16 MiB:WAL 写到 16MB 就自动触发一次 checkpoint。写入密集的场景可以调低(更勤快地把 WAL 落盘、控制文件水位);只读或低频写入场景调高也没关系。理解了这个默认值,你才能解释"为什么我的 .duckdb 文件在持续变大"——通常就是 WAL 增长触发了 checkpoint、而文件不截断所致。
八、什么时候用什么(决策表)
| 你的诉求 | 正确动作 |
|---|---|
| 删了很多行,想别再膨胀 / 让空闲空间可复用 | CHECKPOINT(或依赖自动 wal_autocheckpoint) |
想让磁盘上的 .duckdb 真正变小 | COPY FROM DATABASE 拷进新库再替换 |
| 列统计过期、查询计划变差 | VACUUM my_table(my_col) 重建统计 |
误以为是 VACUUM FULL | 1.5 下 不支持,会报 Not implemented |
| 带主键/唯一约束的表想压缩 | vacuum_rebuild_indexes(实验性,需启动期配置) |
| 内存常驻库反复增删 | ATTACH ':memory:' (...) (COMPRESS) + CHECKPOINT(1.4+) |
继续深入
- DuckDB 完整使用指南 — 从安装到进阶的整体路线图
- DuckDB 性能调优终极指南 — 空间回收只是性能的一环,配合调优一起看
- DuckDB 谓词下推与索引 —
VACUUM ANALYZE重建的统计如何驱动优化器 - DuckDB 生产环境部署指南 — 生产里怎么做"压缩重写 + 原子替换"的安全运维
可复现验证
- 版本:DuckDB 1.5.2 (Variegata),Linux x86_64,CLI 直接执行,所有体积数字用
stat -c '%s'实测。 - 复现命令:
duckdb exp.duckdb < setup.sql按第二、五节顺序跑;压缩对比用第五节COPY FROM DATABASE。 - 官方依据:VACUUM Statement (1.5)、CHECKPOINT Statement (1.5)、Reclaiming Space (1.5)、Configuration (1.5)。
- 本文信息:最后验证 2026-11-17。如发现问题,欢迎通过 GitHub Issue 反馈。