一个老牌 MOLAP,和一个新派列式引擎
Essbase 是 MOLAP 的代表:数据按立方体组织,上卷、钻取、公式成员都是它的本行,短板是报表灵活性和大批量离线分析——想换个角度切数据,往往要等报表开发或者在 Smart View 里慢慢拉。DuckDB 是这几年起来的一派:列式存储、向量化执行、一个文件就是一个库,强项恰好是大批量扫描聚合。
把 Essbase 的数据导出到 DuckDB 做离线分析,听起来是顺理成章的组合。但动手前先检索了一圈:公开渠道找不到一篇现成案例——没有实测博客、没有开源项目、没有厂商连接器,只有软件对比站自动生成的产品介绍页。桥的两半各自存在(Essbase 有官方导出和 Python API,DuckDB 什么文件都能读),中间没人搭过。本文就把这两条路线完整实跑一遍,并且按财务对账的标准验:DuckDB 侧的上卷结果,必须和 Essbase 侧逐项对上。
环境:DuckDB v2.0.0(Python)。数据是按 Essbase 自带示例库 Sample Basic 的大纲形状生成的仿真数据:5 个 0 级科目(Sales、COGS、Marketing、Payroll、Misc)、13 个产品、20 个州、12 个月、Actual 与 Budget 两个场景,约 45% 的单元格为空(稀疏是 Essbase 立方体的常态,导出时空单元格不出现)。仿真数据的每个汇总值都有独立生成的真值可对,不影响结论:要验的是管线和口径,不是某个企业的经营数字。
先说清楚:它解决了什么问题
这条管线不是为了替代 Essbase,而是解 Essbase 日常使用里四个具体的痛点:
一、对数靠人肉,账对不平还找不到原因。 预算数与实际数、相邻两个系统之间的数对不上,是预算岗的常态。现在的做法是两边各拉一张表,Excel 里逐项比。问题是拉出来的往往已经是汇总数,差异定位不到成员级。这条管线把 0 级全量搬出来复算:每一项上卷都能追到 0 级成员,差异为 0 就是为 0,对不平也能立刻下钻定位是哪几个成员、哪个场景的差。本文的对数环节对的就是这个场景。
二、改规则之前没法低成本试算。 分摊规则、计算逻辑改一个口径,影响面有多大,往常只能在测试环境全量重跑,或者干脆上了生产再看。生产库跑一轮全量计算以十分钟计,月结高峰期还锁块,试错成本极高。离线副本不碰生产:528 万行数据全量上卷 0.01 秒,新旧两种口径各算一遍 diff 出来,影响范围先在副本上看清,再决定要不要动生产规则。
三、临时取数慢,还怕拖垮填报。 Smart View 拉大范围数据有行数和超时限制,分批拉、慢慢等是常态;在生产库上跑一个全量扫描,又怕影响正在填报的人。副本在自己机器上,百万级聚合百分之几秒,随便切维度、换角度,不用排队,不用看生产库的脸色。
四、跨系统拼接做不了。 Essbase 的数要和外部数据(其他系统导出、Excel 台账、文本文件)对着看时,在 Essbase 里没有办法,只能先导出来再拼——导出来之后用什么拼,就是这条管线的活:DuckDB 对 CSV、Parquet、Excel、JSON 都是直读,多源 join 一条 SQL 解决。
四个痛点有一个共同点:都不是 Essbase 算错了,而是它的计算资源太贵、太集中,不适合反复试、随便查。离线副本的价值就是把「查」和「算」分开:生产库管填报和正式计算,副本管分析和试错。
路线一:导出 0 级数据,DuckDB 直读
Essbase 侧的动作是标准操作:用 DATAEXPORT 计算脚本或 MaxL 把 0 级数据导成文本(非列格式,每行一个完整成员交叉点加一个数值):
FIX ("Actual", "Budget")
  DATAEXPORT "File" " " "basic_level0.txt";
ENDFIX
导出文件长这样(成员带引号、空格分隔、数值在行尾):
"Jan" "Sales" "100-10" "New York" "Actual" 4013.82
"Jan" "Sales" "100-10" "California" "Actual" 2981.55
DuckDB 侧不需要任何导入程序,read_csv 直接把文本读成表——引号和分隔符都是参数:
CREATE TABLE fact AS
SELECT * FROM read_csv('basic_level0.txt', header = false, sep = ' ', quote = '"',
  columns = {'Month':'VARCHAR', 'Measures':'VARCHAR', 'Product':'VARCHAR',
             'Market':'VARCHAR', 'Scenario':'VARCHAR', 'Value':'DOUBLE'});
-- 17,068 行,实测 0.04 秒
光有事实表还不够。Essbase 的上卷靠大纲层级,DuckDB 侧要把层级变成表:从大纲导出成员与父项,做成 product_hier(member, parent, rollup) 和 market_hier(member, parent) 两张小表。之后任意上卷就是一次连接加分组:
SELECT h.parent AS category, sum(f.Value) AS sales
FROM fact f
JOIN product_hier h ON h.member = f.Product AND h.rollup = 'primary'
WHERE f.Measures = 'Sales' AND f.Scenario = 'Actual'
GROUP BY 1 ORDER BY 1;
| category | sales |
|---|---|
| 100 | 1745240.44 |
| 200 | 2558852.13 |
| 300 | 1883168.76 |
| 400 | 1869248.40 |
对数结果:这四个品类值、市场五大区域的上卷值、Sales 全量总计 8,056,509.73,与真值逐项比对,差异全部为 0。这一步是整条路线的可信度根基:口径对上了,后面的分析才有意义。
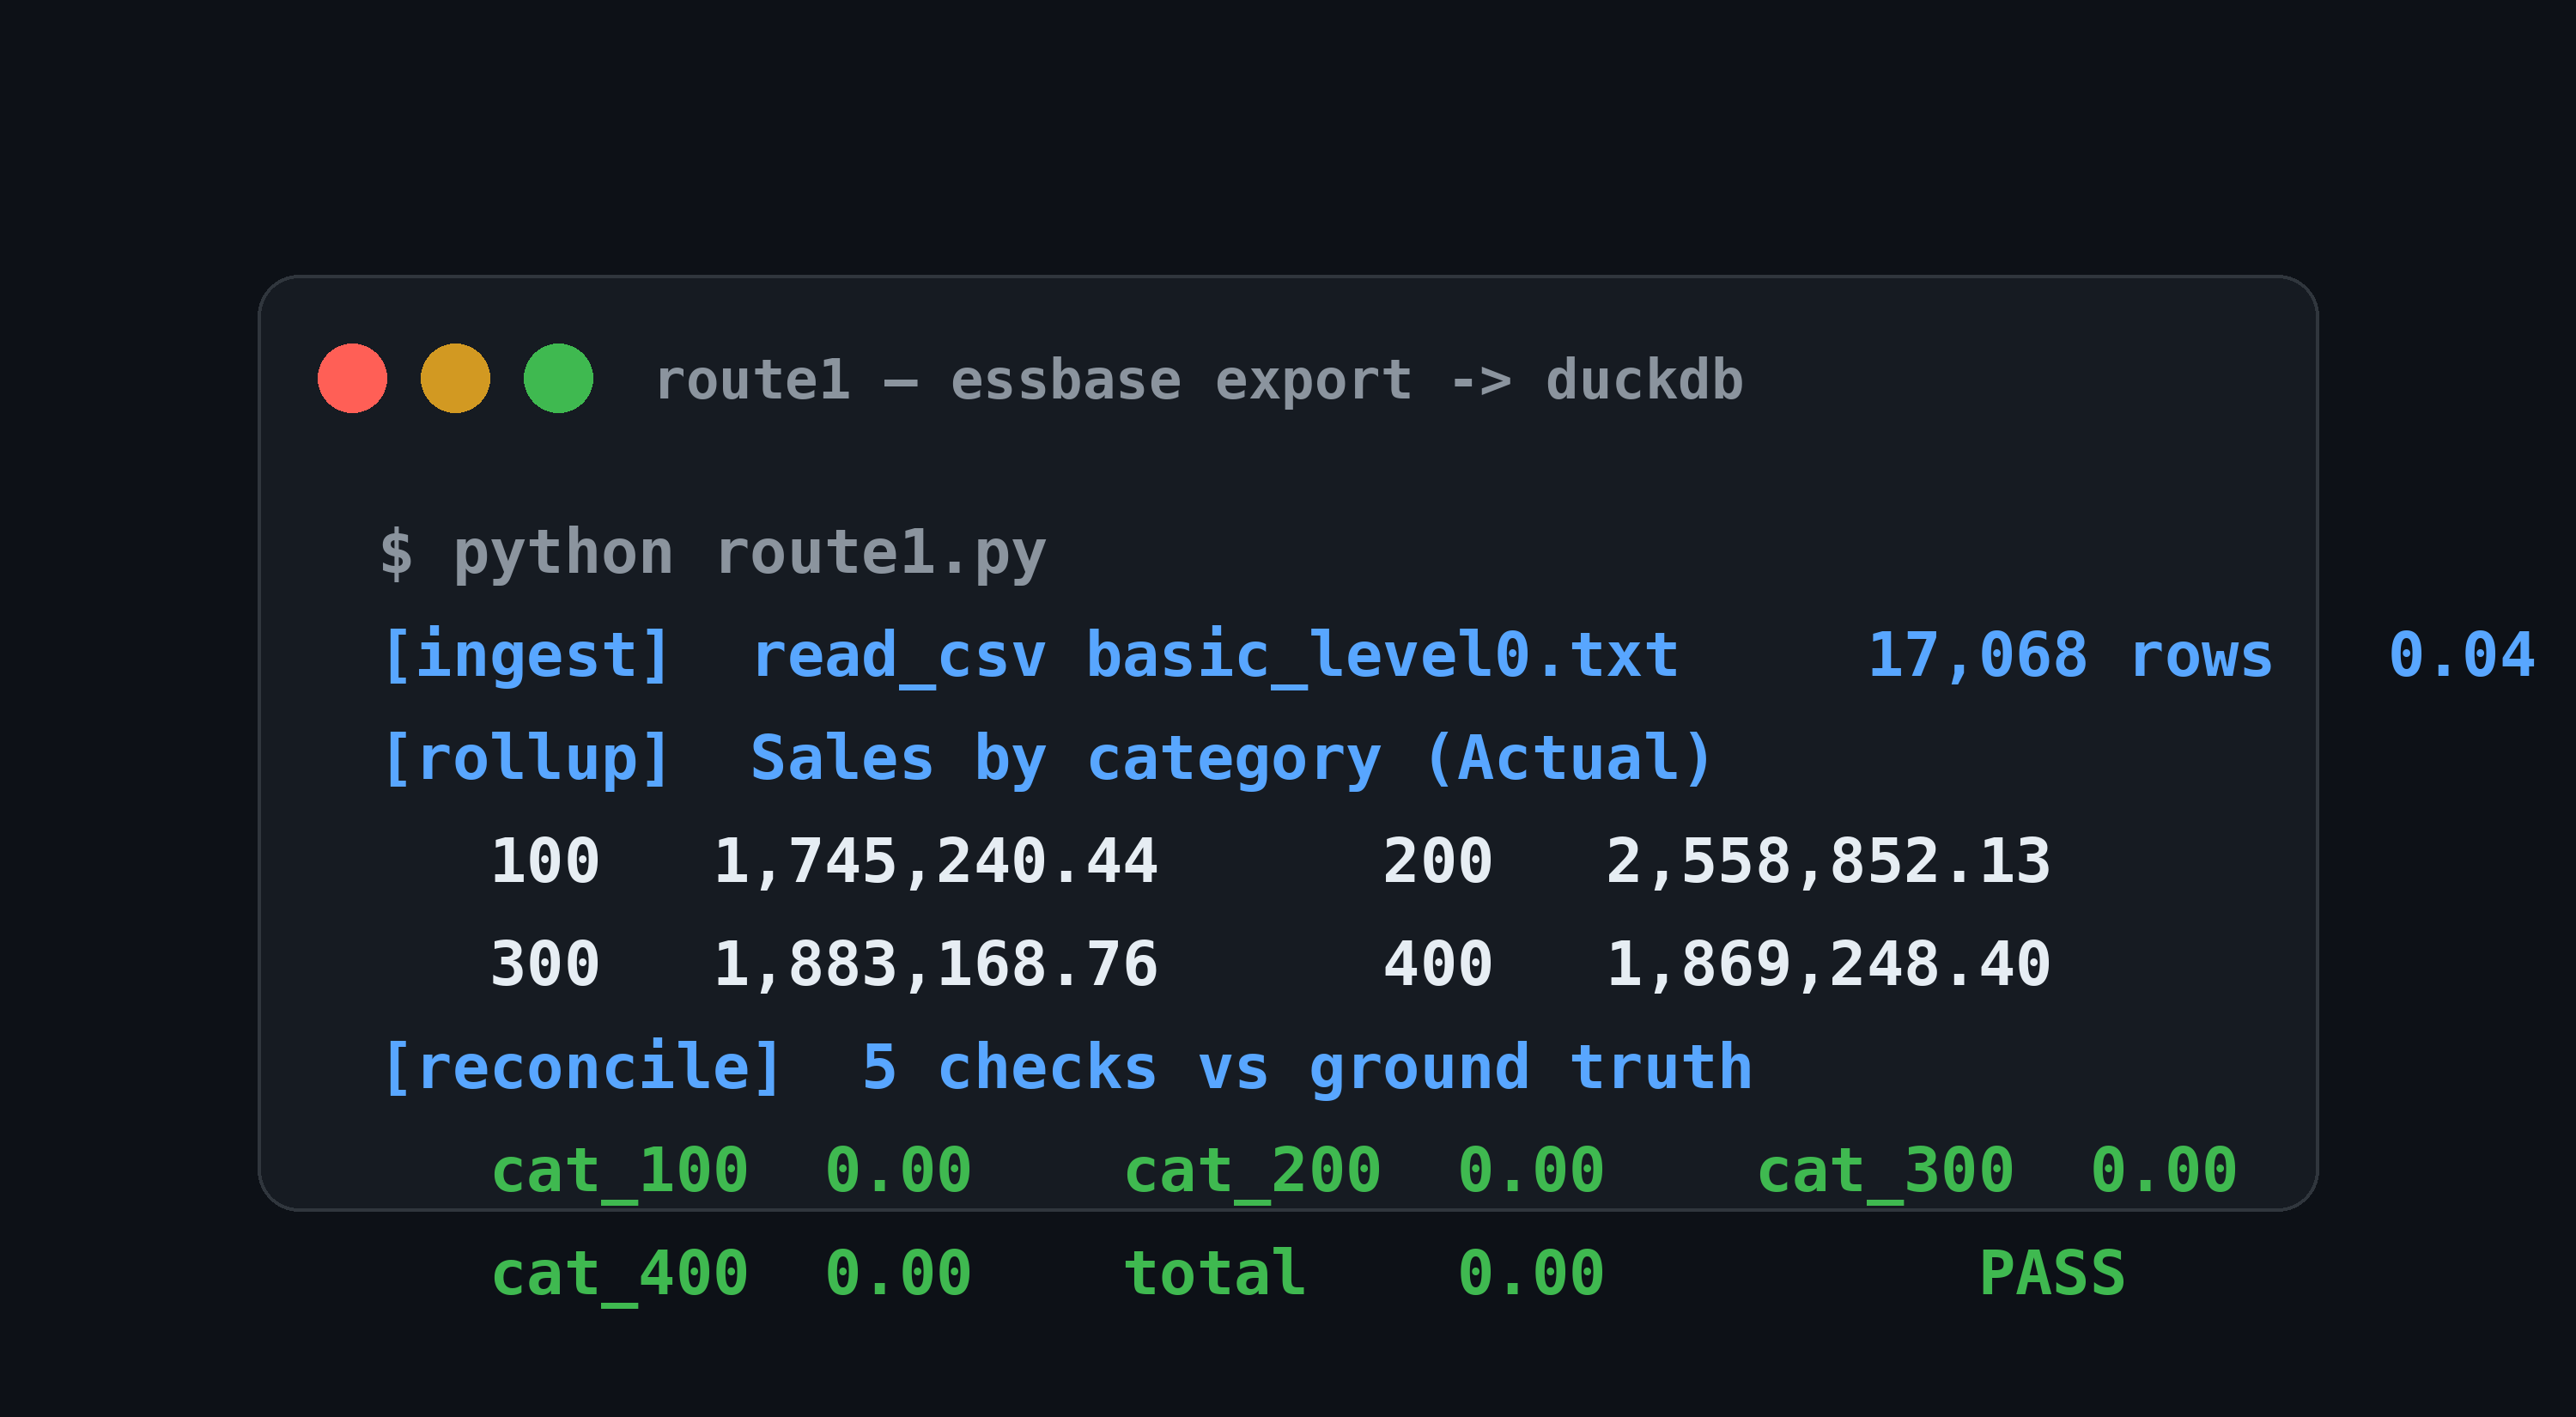
图 1:路线一实跑输出——0 级导出入库 0.04 秒,品类上卷与对数五项差异均为 0.00。
Essbase 特色一:替代汇总(共享成员)
Sample Basic 里 Diet 是替代汇总:100-20、200-20、300-30 三个产品既属于各自品类,又被 Diet 再汇总一次(Essbase 里靠共享成员实现)。关系型模型处理这个并不难——层级表加一列 rollup 区分主汇总与替代汇总,成员在表里出现两次即可:
SELECT sum(f.Value) FROM fact f
JOIN product_hier h ON h.member = f.Product AND h.parent = 'Diet'
WHERE f.Measures = 'Sales' AND f.Scenario = 'Actual';
-- 1782909.84,与真值差异 0
要点是别把替代汇总混进主汇总的层级链,否则总计会重复计算——这和在 Essbase 里分清存储成员与共享成员是同一件事。
Essbase 特色二:公式成员在 SQL 侧复算
Profit 在 Sample Basic 里是公式成员(Sales 减 COGS、Marketing、Payroll、Misc),不落 0 级数据。导出文件里没有它,DuckDB 侧用条件聚合一行复算:
SELECT sum(Value * CASE Measures WHEN 'Sales' THEN 1 ELSE -1 END) AS profit
FROM fact WHERE Scenario = 'Actual';
-- 2152890.95,与真值差异 0
这也划出了这条路线的口径边界:公式成员有多少,SQL 侧就要维护多少口径定义。科目少时是几行 CASE,到了真实预算系统成百上千个公式成员,就需要一份可维护的口径层——这是产品化时真正的工作量,不在这条管线本身。
放大测试:528 万行
Sample Basic 的量级只够验口径。再生成一版放大数据:加一个 100 个组织的组织维度、产品扩到 200 个 SKU、市场取区域级,共 5,281,142 行 0 级数据,导出文本 317 MB。同一台机器实测:
| 环节 | 结果 |
|---|---|
| 文本入库 DuckDB | 5.77 秒 |
| 转 Parquet(ZSTD) | 2.33 秒,317 MB → 21 MB(14.0 倍) |
| 全量上卷(Sales 总计) | 0.01 秒 |
| 按组织汇总取 Top 10 | 0.01 秒 |
| Actual vs Budget 全产品差异分析 | 0.02 秒 |
差异分析是这类离线场景最常见的活,在 Essbase 里通常要一张专门的报表,在 DuckDB 里是一句带 FILTER 的聚合:
SELECT Product,
       sum(Value) FILTER (Scenario = 'Actual')
     - sum(Value) FILTER (Scenario = 'Budget') AS var
FROM fact_scaled WHERE Measures = 'Sales'
GROUP BY 1 ORDER BY abs(var) DESC LIMIT 5;
-- 差异最大:SKU-0057,Actual 比 Budget 少 1,553,495.11
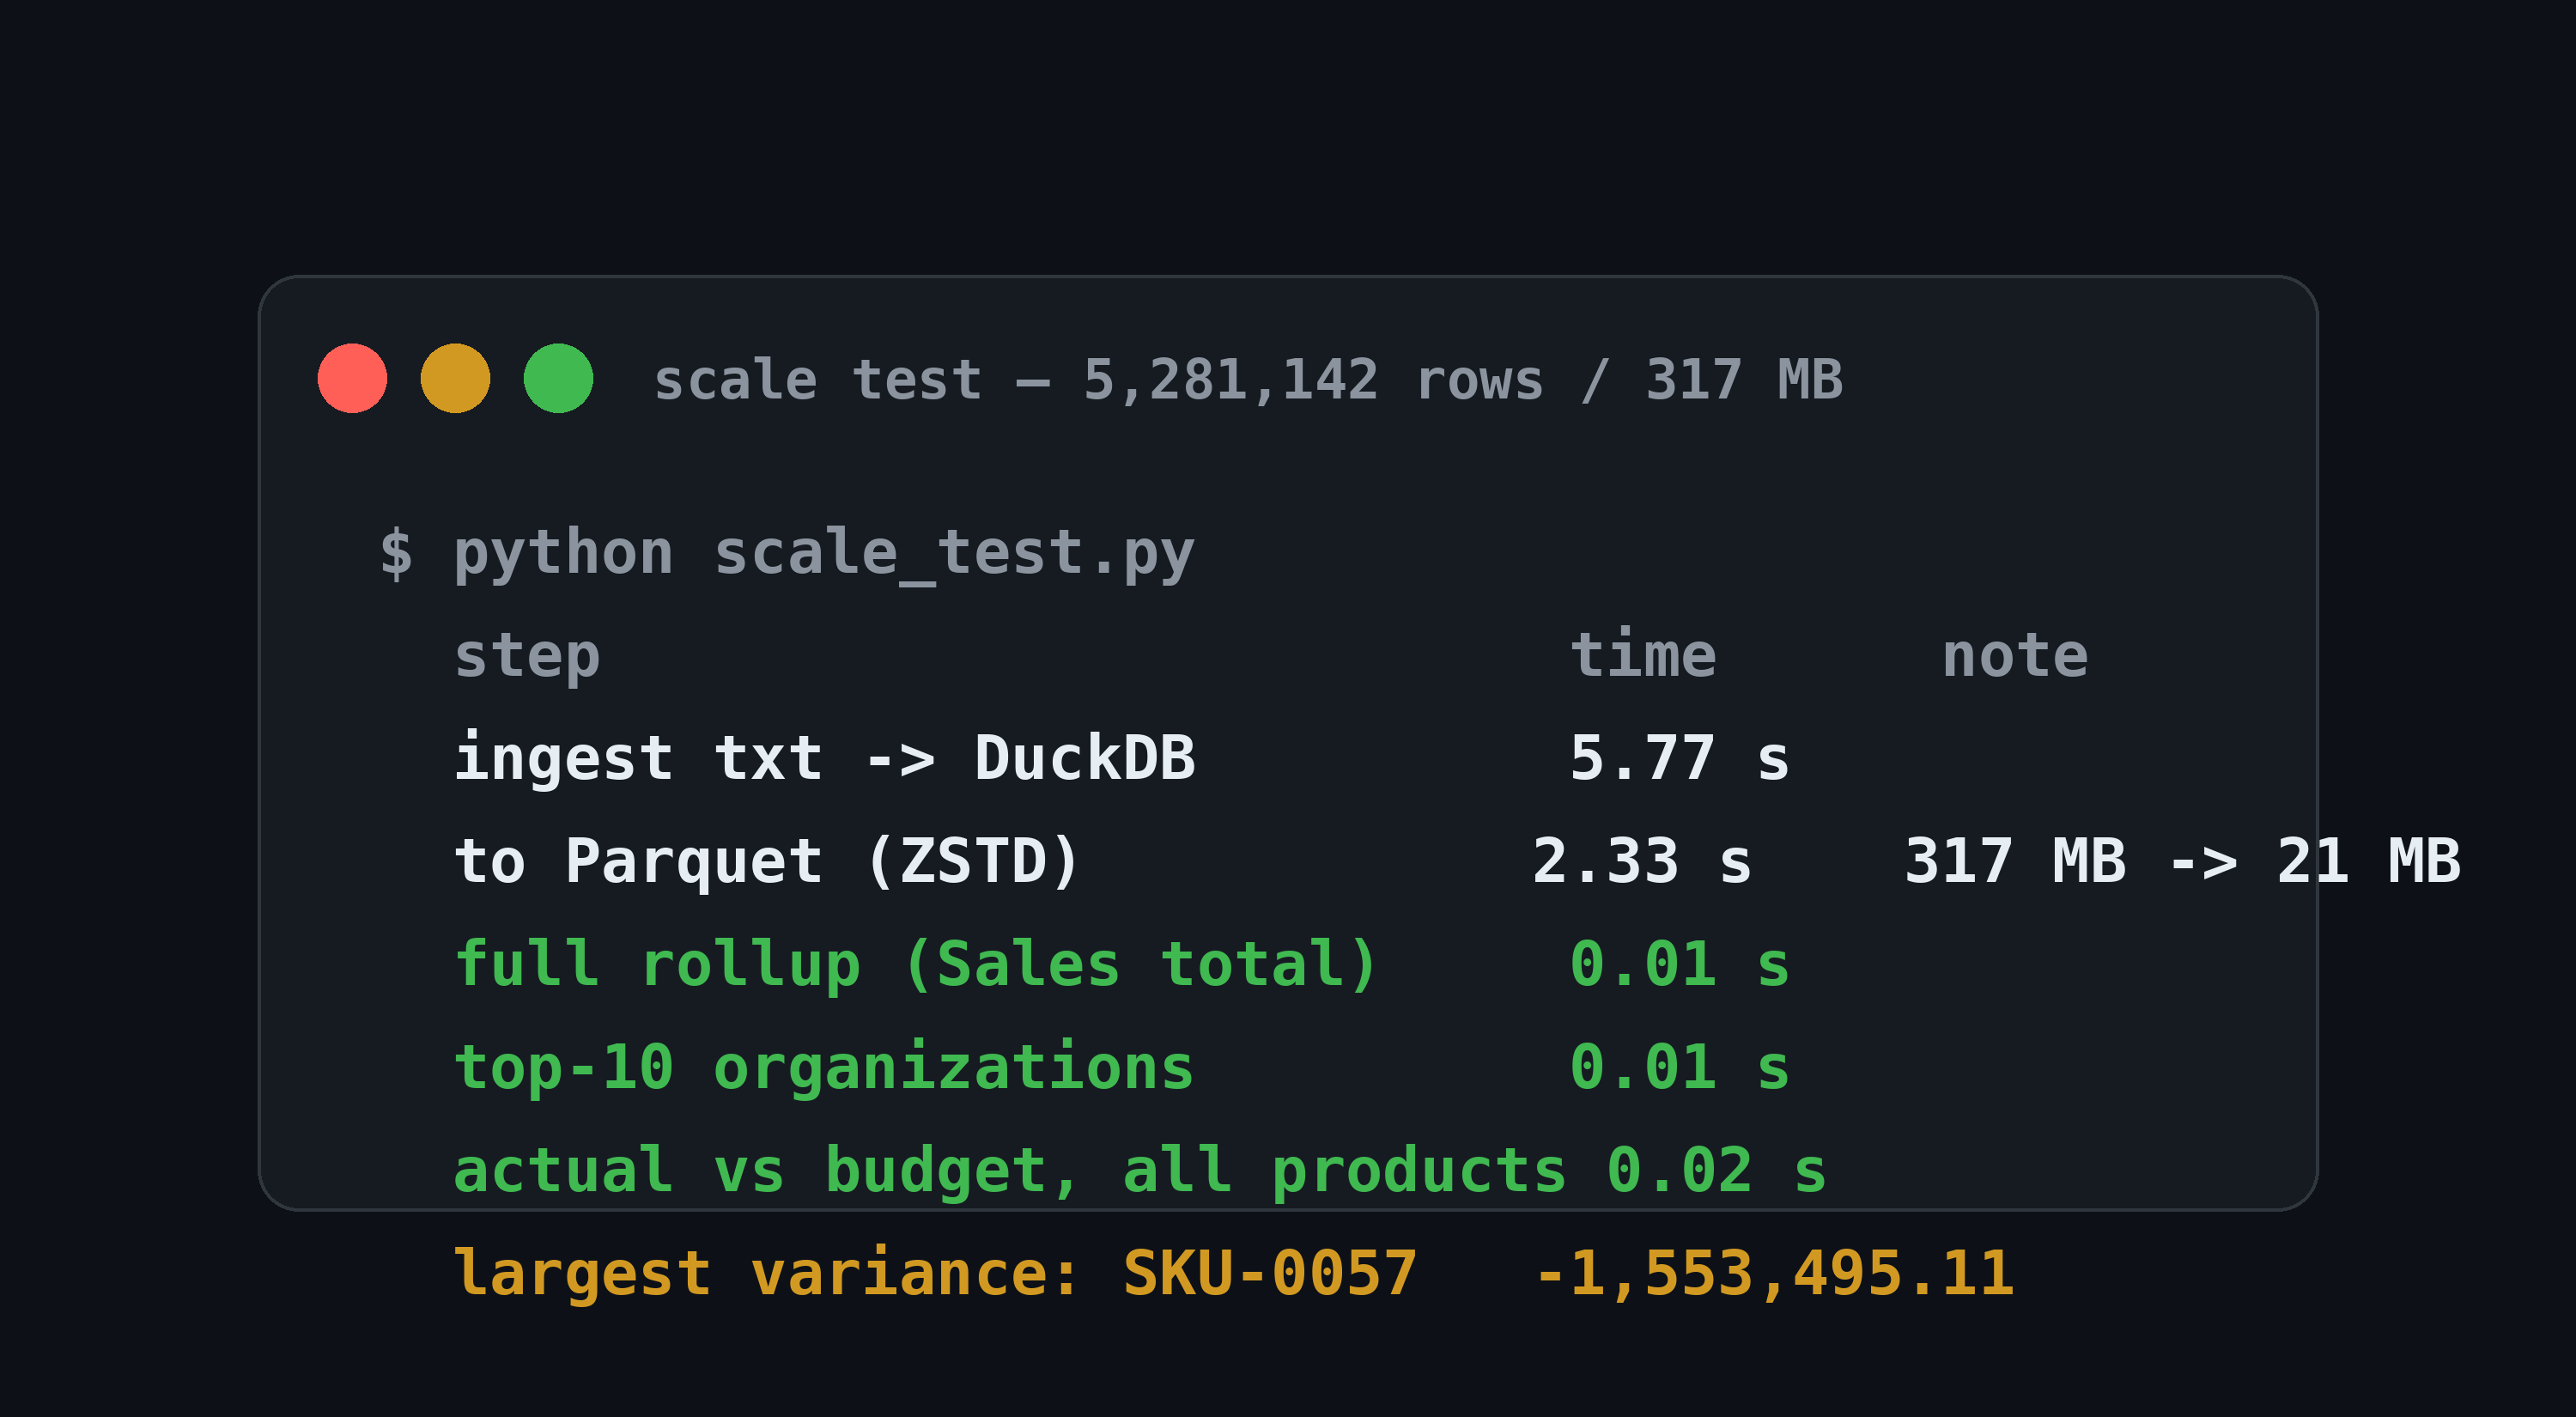
图 2:放大测试实跑输出——5,281,142 行入库 5.77 秒,Parquet 压缩 14.0 倍,三项分析查询均在 0.02 秒内。
路线二:Essbase 21c 的 Python API
21c 之后 Oracle 给了官方 Python 包 oracle-data-studio(导入名 essbase),能直接在 Python 里跑 MDX,结果展平成记录列表。先核实包本身:PyPI 可装,当前版本 1.0.37;connect(url, username, password)、Database.mdx_records(query)、mdx_to_records() 都真实存在,与 Oracle 官方博客的描述一致。
import essbase, pandas as pd, duckdb

with essbase.connect(url, user, password) as ess:
    db = ess.applications['Sample'].databases['Basic']
    records = db.mdx_records("""
        SELECT {[Measures].[Sales]} ON COLUMNS,
               CROSSJOIN({[Year].Children}, {[Product].Children}) ON ROWS
        FROM Basic WHERE ([Market].[East], [Scenario].[Actual])""")

df = pd.DataFrame(records)
duckdb.sql("SELECT Product, sum(Sales) FROM df GROUP BY 1")
本机验证的范围要说清:用官方「axes + cells」响应形状构造了同一批数据的 MDX 响应样本(156 个单元格),官方 mdx_to_records 展平为 156 条记录,进 DuckDB 按产品汇总,与真值逐项比对,总计 1,974,941.30、差异为 0。实连一台 21c 服务器跑真 MDX 这一步没有在本机完成——展平之后到 DuckDB 的半程已验通,连服务器的半程只有接口核实。另外这条路线只适用于 21c 与 Essbase Cloud;11.x 的在位系统没有这个 API,老老实实走路线一。
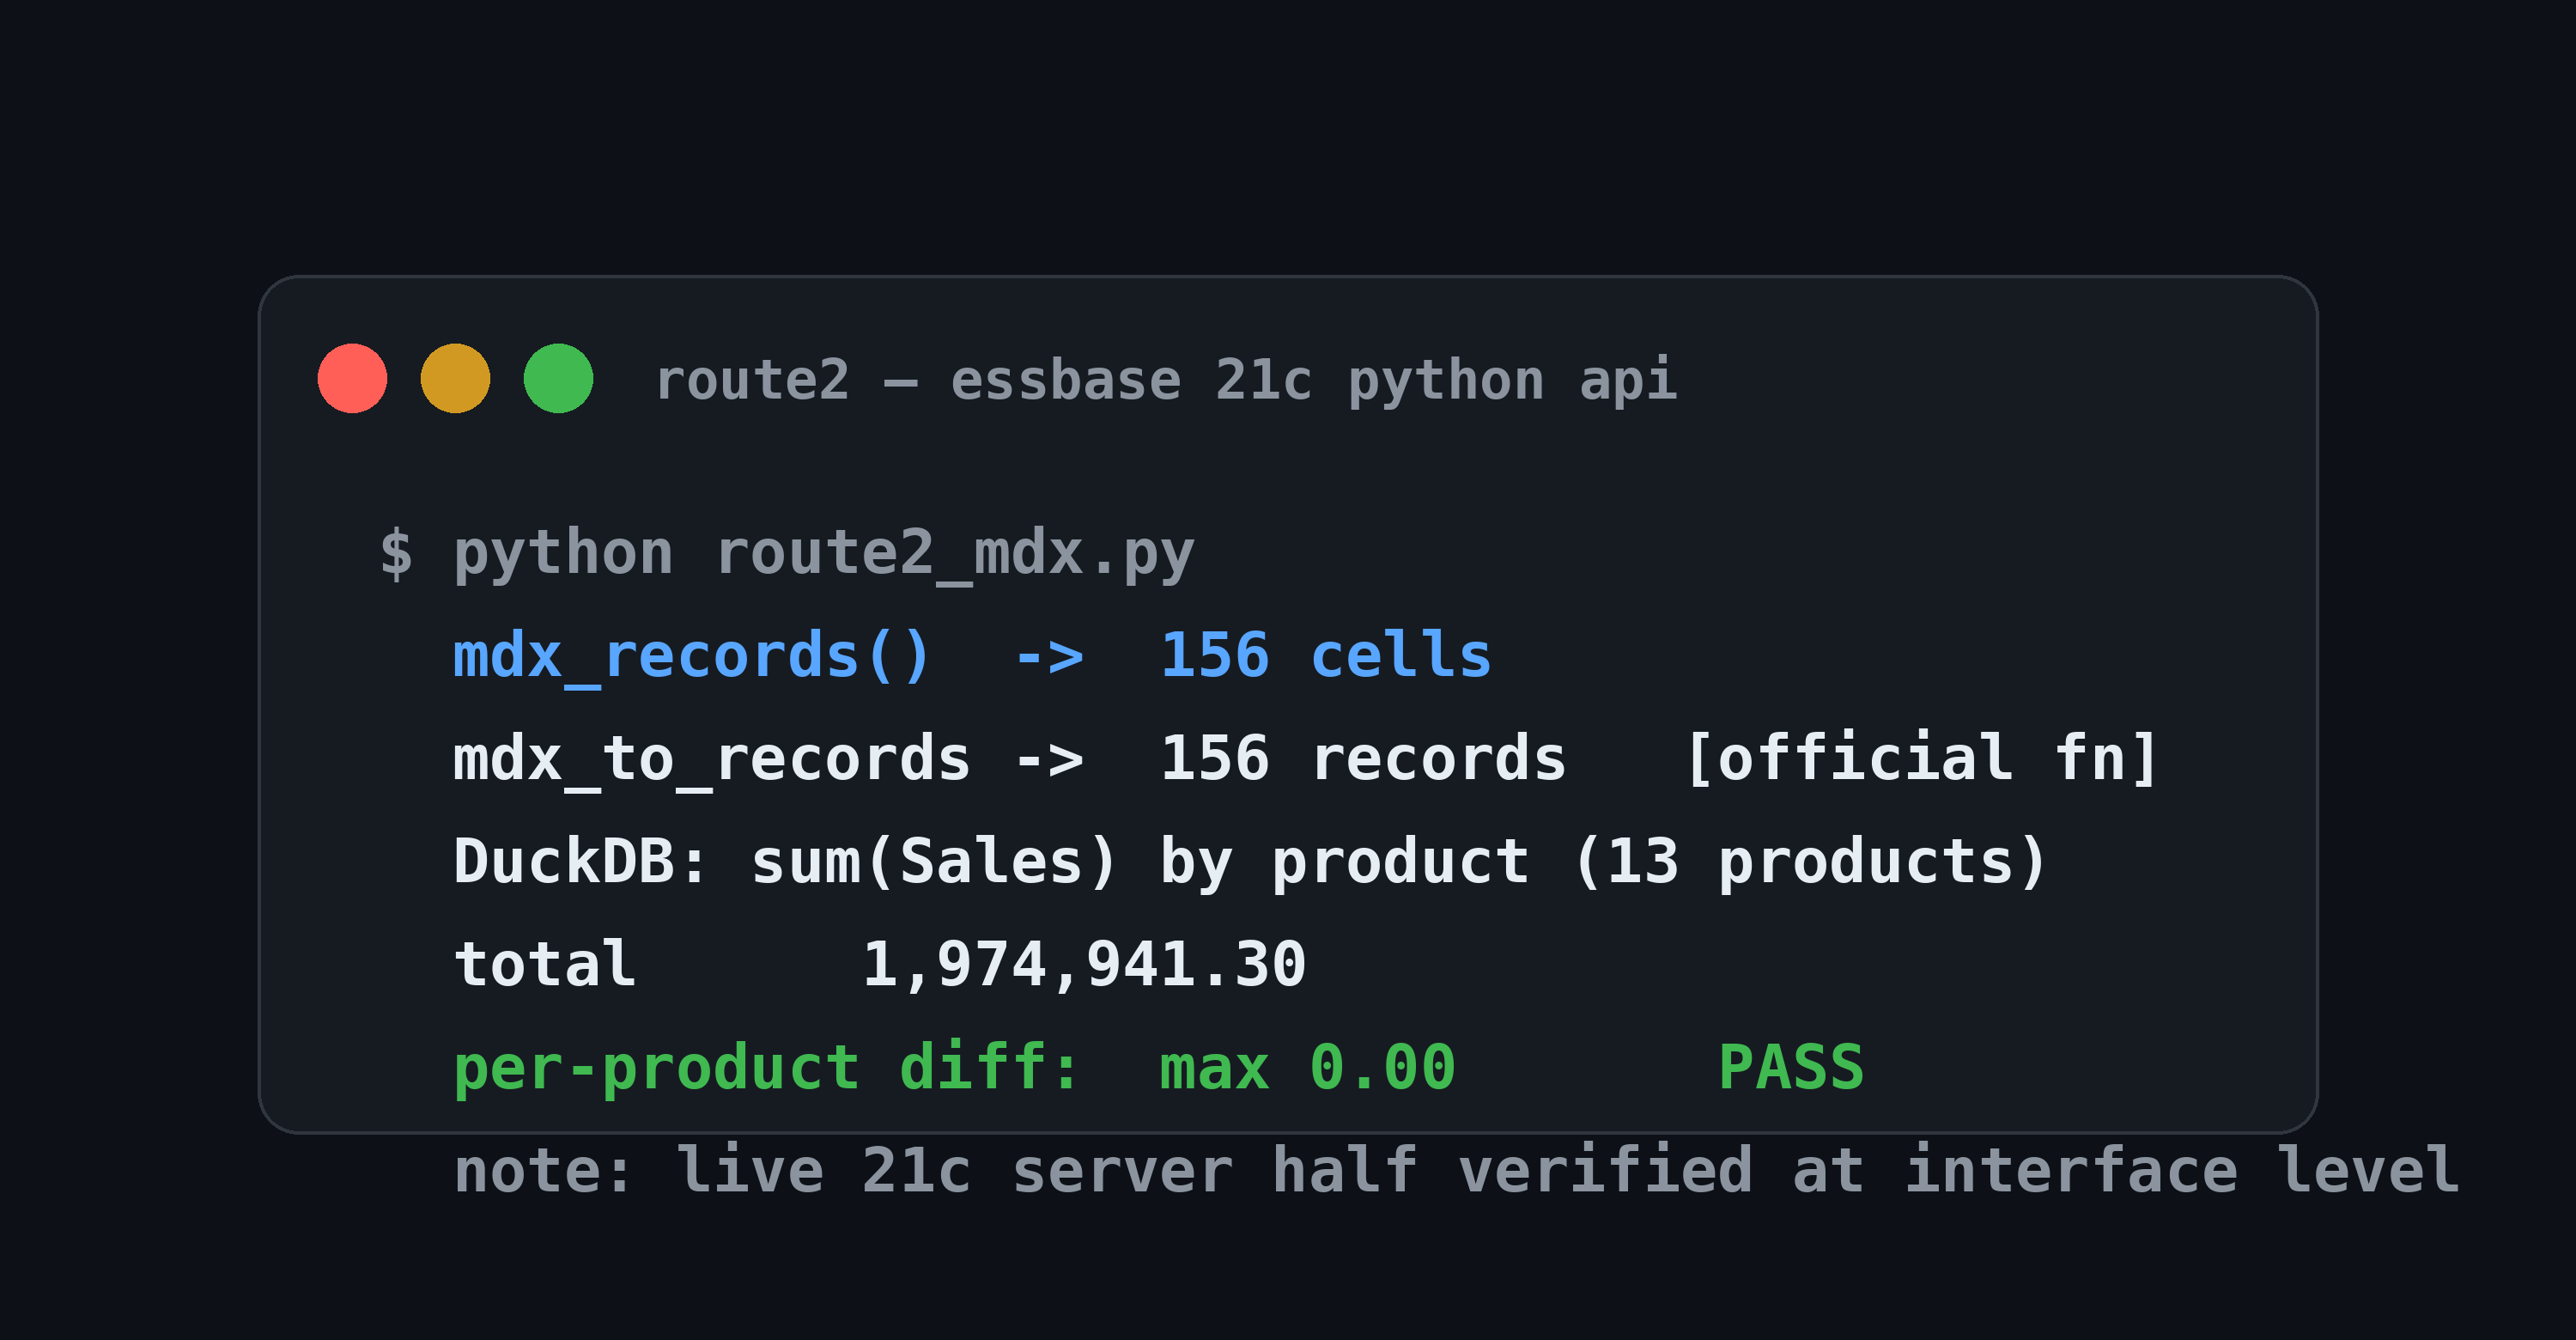
图 3:路线二后半程实跑输出——MDX 响应经官方函数展平为记录,进 DuckDB 汇总对数,总计与逐产品差异均为 0。
边界
- 只读,不写回。 这条管线是把数据搬出来分析,预算填报、计算脚本执行还留在 Essbase 里,别指望替代。
- 上级值靠即时聚合。 Essbase 的上级成员值是存储或动态计算出来的,DuckDB 侧是拿 0 级全量即时上卷——对数的前提是导出范围完整,少导一个场景,数就对不上,而且是对不上得理直气壮。
- 账号权限语义不迁移。 Essbase 的过滤器、元读权限不会跟着导出文件走,离线副本要自己管脱敏和访问控制。
结论
两条路线都通:全版本走导出文件,21c 多一个直连 API 的选择。528 万行量级下,入库以秒计、上卷以百分之几秒计,且每一项汇总都能和源头对到差异为 0。回到开头那四个问题——对数能下钻到成员级、改规则能先在副本上试算、临时取数不排队不拖生产、跨系统数据能直接拼——解的都是同一件事:给 Essbase 配一个便宜、随便用的离线副本。源系统不动,这不是迁移方案。
继续深入
- DuckDB CSV 导入完全指南 — 路线一用到的
read_csv完整用法 - DuckDB 高级 SQL 技巧 — 让这条管线更进一步的可复用模式