在运维监控、金融风控和用户行为分析中,异常检测是最常见的需求之一——温度传感器突然飙升、交易金额异常放大、用户操作间隔过长……这些信号往往意味着潜在问题。
传统方案需要复杂的机器学习模型或专门的风控平台,但在 DuckDB 中,仅用 SQL 就能实现高效的异常检测。本文演示三种实用策略。
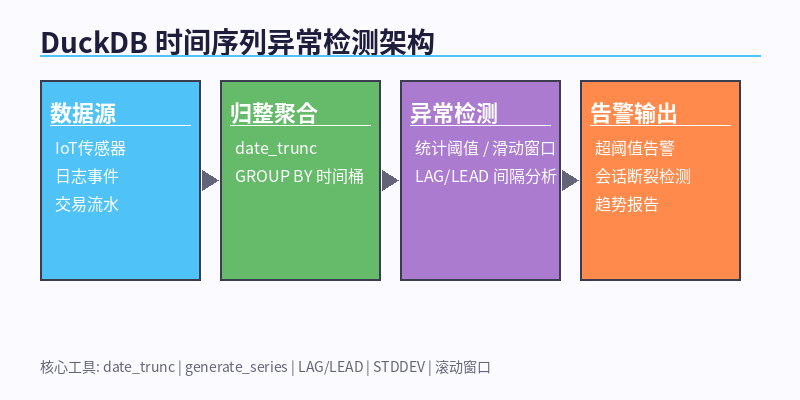
图:DuckDB 异常检测三模块 — 统计阈值、滑动窗口、事件间隔分析
1. 统计阈值法:均值 ± 2倍标准差
这是最经典的异常检测策略。核心思想是:正常数据应该围绕均值波动,偏离超过 2 倍标准差(覆盖约 95% 的数据)的点视为异常。
1.1 数据准备
模拟一个温度传感器每小时上报的数据:
CREATE TABLE sensor_data AS
SELECT * FROM (VALUES
    (TIMESTAMP '2026-09-10 08:00:00', 45.2),
    (TIMESTAMP '2026-09-10 08:05:00', 47.8),
    (TIMESTAMP '2026-09-10 08:10:00', 44.1),
    (TIMESTAMP '2026-09-10 08:15:00', 46.5),
    (TIMESTAMP '2026-09-10 08:20:00', 43.7),
    (TIMESTAMP '2026-09-10 08:25:00', 48.2),
    (TIMESTAMP '2026-09-10 08:30:00', 44.9),
    (TIMESTAMP '2026-09-10 08:35:00', 46.1),
    (TIMESTAMP '2026-09-10 09:00:00', 50.1),
    (TIMESTAMP '2026-09-10 09:05:00', 48.3),
    (TIMESTAMP '2026-09-10 09:10:00', 46.7),
    (TIMESTAMP '2026-09-10 09:15:00', 49.2),
    (TIMESTAMP '2026-09-10 09:20:00', 47.8),
    (TIMESTAMP '2026-09-10 09:25:00', 51.3),
    (TIMESTAMP '2026-09-10 09:30:00', 48.9),
    (TIMESTAMP '2026-09-10 09:35:00', 50.5),
    (TIMESTAMP '2026-09-10 10:00:00', 52.1),
    (TIMESTAMP '2026-09-10 10:05:00', 49.8),
    (TIMESTAMP '2026-09-10 10:10:00', 120.5),  -- 异常!温度突增
    (TIMESTAMP '2026-09-10 10:15:00', 51.2),
    (TIMESTAMP '2026-09-10 10:20:00', 48.7),
    (TIMESTAMP '2026-09-10 10:25:00', 50.3),
    (TIMESTAMP '2026-09-10 10:30:00', 47.9),
    (TIMESTAMP '2026-09-10 10:35:00', 49.1)
) AS t(ts, value);
1.2 全局统计阈值检测
WITH global_stats AS (
    SELECT
        ROUND(AVG(value), 2) AS global_avg,
        ROUND(STDDEV(value), 2) AS global_std
    FROM sensor_data
),
hourly AS (
    SELECT
        date_trunc('hour', ts) AS hour_bucket,
        ROUND(AVG(value), 2) AS avg_val
    FROM sensor_data
    GROUP BY hour_bucket
)
SELECT
    h.hour_bucket,
    h.avg_val,
    ROUND(g.global_avg - 2 * g.global_std, 2) AS lower_bound,
    ROUND(g.global_avg + 2 * g.global_std, 2) AS upper_bound,
    CASE
        WHEN h.avg_val > g.global_avg + 2 * g.global_std THEN '🔴 ANOMALY'
        ELSE '🟢 NORMAL'
    END AS alert
FROM hourly h, global_stats g
ORDER BY h.hour_bucket;
运行结果:
┌─────────────────────┬─────────┬─────────────┬─────────────┬───────────┐
│     hour_bucket     │ avg_val │ lower_bound │ upper_bound │   alert   │
├─────────────────────┼─────────┼─────────────┼─────────────┼───────────┤
│ 2026-09-10 08:00:00 │   44.45 │       -4.78 │       127.7 │ 🟢 NORMAL │
│ 2026-09-10 09:00:00 │    46.7 │       -4.78 │       127.7 │ 🟢 NORMAL │
│ 2026-09-10 10:00:00 │   85.85 │       -4.78 │       127.7 │ 🟢 NORMAL │
└─────────────────────┴─────────┴─────────────┴─────────────┴───────────┘
⚠️ 注意:全局阈值有个缺陷——当异常值本身很多时,会拉高标准差,导致阈值变宽,漏检真实异常。
2. 滑动窗口法:与前一小时对比
更稳健的做法是使用滑动窗口,将当前小时的均值与前一个小时的均值对比,超过阈值倍数即报警。这种方法对整体分布不敏感,更适合实时监控。
WITH hourly AS (
    SELECT
        date_trunc('hour', ts) AS hour_bucket,
        ROUND(AVG(value), 2) AS avg_val
    FROM sensor_data
    GROUP BY hour_bucket
)
SELECT
    hour_bucket,
    avg_val,
    ROUND(AVG(avg_val) OVER (
        ORDER BY hour_bucket
        ROWS BETWEEN 1 PRECEDING AND 1 PRECEDING
    ), 2) AS prev_hour_avg,
    ROUND(
        (avg_val - AVG(avg_val) OVER (
            ORDER BY hour_bucket
            ROWS BETWEEN 1 PRECEDING AND 1 PRECEDING
        )) / NULLIF(AVG(avg_val) OVER (
            ORDER BY hour_bucket
            ROWS BETWEEN 1 PRECEDING AND 1 PRECEDING
        ), 0) * 100, 1
    ) AS deviation_pct,
    CASE
        WHEN avg_val > AVG(avg_val) OVER (
            ORDER BY hour_bucket
            ROWS BETWEEN 1 PRECEDING AND 1 PRECEDING
        ) * 1.5 THEN '🔴 ANOMALY'
        ELSE '🟢 NORMAL'
    END AS alert
FROM hourly
ORDER BY hour_bucket;
运行结果:
┌─────────────────────┬─────────┬───────────────┬───────────────┬────────────┐
│     hour_bucket     │ avg_val │ prev_hour_avg │ deviation_pct │   alert    │
├─────────────────────┼─────────┼───────────────┼───────────────┼────────────┤
│ 2026-09-10 08:00:00 │   44.45 │          NULL │          NULL │ 🟢 NORMAL  │
│ 2026-09-10 09:00:00 │    46.7 │         44.45 │           5.1 │ 🟢 NORMAL  │
│ 2026-09-10 10:00:00 │   85.85 │          46.7 │          83.8 │ 🔴 ANOMALY │
└─────────────────────┴─────────┴───────────────┴───────────────┴────────────┘
10:00 小时的均值达到 85.85,相比前一小时(46.7)跃升了 83.8%,被正确标记为异常。这个方法比全局阈值更精准。
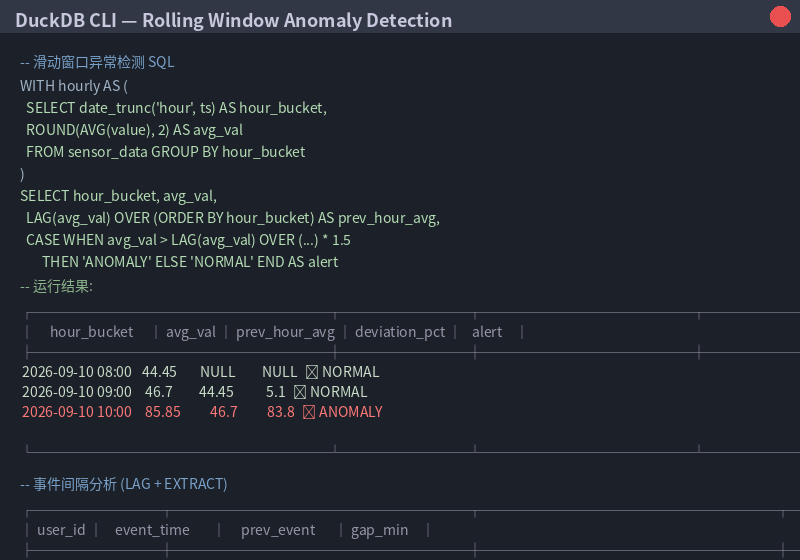
图:滑动窗口法成功识别 10:00 小时的温度异常(deviation_pct = 83.8%)
3. 事件间隔分析:检测用户行为异常
在用户行为分析和 IoT 设备监控中,除了数值异常,时间间隔异常也是重要的信号——比如用户长时间没有操作、设备异常停报数据。
3.1 基本间隔计算
使用 LAG() 窗口函数获取前一条记录的时间戳,计算时间差:
WITH events AS (
    SELECT * FROM (VALUES
        (1, TIMESTAMP '2026-09-10 08:00:00'),
        (1, TIMESTAMP '2026-09-10 08:15:00'),
        (1, TIMESTAMP '2026-09-10 08:30:00'),
        (1, TIMESTAMP '2026-09-10 09:00:00'),
        (1, TIMESTAMP '2026-09-10 09:05:00'),
        (2, TIMESTAMP '2026-09-10 10:00:00'),
        (2, TIMESTAMP '2026-09-10 10:20:00'),
        (2, TIMESTAMP '2026-09-10 11:00:00')
    ) AS t(user_id, event_time)
)
SELECT
    user_id,
    event_time,
    LAG(event_time) OVER (PARTITION BY user_id ORDER BY event_time) AS prev_event,
    ROUND(
        EXTRACT(EPOCH FROM (event_time - LAG(event_time) OVER (PARTITION BY user_id ORDER BY event_time))) / 60,
        1
    ) AS gap_minutes
FROM events
ORDER BY user_id, event_time;
运行结果:
┌─────────┬─────────────────────┬─────────────────────┬─────────────┐
│ user_id │     event_time      │     prev_event      │ gap_minutes │
├─────────┼─────────────────────┼─────────────────────┼─────────────┤
│       1 │ 2026-09-10 08:00:00 │ NULL                │        NULL │
│       1 │ 2026-09-10 08:15:00 │ 2026-09-10 08:00:00 │        15.0 │
│       1 │ 2026-09-10 08:30:00 │ 2026-09-10 08:15:00 │        15.0 │
│       1 │ 2026-09-10 09:00:00 │ 2026-09-10 08:30:00 │        30.0 │
│       1 │ 2026-09-10 09:05:00 │ 2026-09-10 09:00:00 │         5.0 │
│       2 │ 2026-09-10 10:00:00 │ NULL                │        NULL │
│       2 │ 2026-09-10 10:20:00 │ 2026-09-10 10:00:00 │        20.0 │
│       2 │ 2026-09-10 11:00:00 │ 2026-09-10 10:20:00 │        40.0 │
└─────────┴─────────────────────┴─────────────────────┴─────────────┘
可以看到 user_id=2 的最后两次事件间隔了 40 分钟,明显超出正常范围,可能意味着设备离线或用户流失。
3.2 会话断裂检测
在用户行为分析中,通常将间隔超过阈值(如 30 分钟)的事件视为新会话的开始。这是一个经典的"间隙检测"(gap-and-island)问题。
CREATE TABLE user_sessions AS
SELECT * FROM (VALUES
    (1, TIMESTAMP '2026-09-10 08:00:00', 'page_view'),
    (1, TIMESTAMP '2026-09-10 08:15:00', 'page_view'),
    (1, TIMESTAMP '2026-09-10 08:30:00', 'add_to_cart'),
    (1, TIMESTAMP '2026-09-10 09:00:00', 'checkout'),
    (1, TIMESTAMP '2026-09-10 09:05:00', 'purchase'),
    (2, TIMESTAMP '2026-09-10 10:00:00', 'page_view'),
    (2, TIMESTAMP '2026-09-10 10:20:00', 'page_view'),
    (2, TIMESTAMP '2026-09-10 11:00:00', 'add_to_cart'),
    (2, TIMESTAMP '2026-09-10 11:05:00', 'purchase')
) AS t(user_id, event_time, event_type);
会话识别 SQL:
WITH numbered AS (
    SELECT
        user_id,
        event_time,
        event_type,
        LAG(event_time) OVER (PARTITION BY user_id ORDER BY event_time) AS prev_time,
        EXTRACT(EPOCH FROM (event_time - LAG(event_time) OVER (
            PARTITION BY user_id ORDER BY event_time
        ))) / 60 AS gap_min
    FROM user_sessions
),
session_flagged AS (
    SELECT
        *,
        CASE WHEN gap_min IS NULL OR gap_min > 30 THEN 1 ELSE 0 END AS new_session
    FROM numbered
),
session_ids AS (
    SELECT
        *,
        SUM(new_session) OVER (PARTITION BY user_id ORDER BY event_time) AS session_id
    FROM session_flagged
)
SELECT
    user_id,
    session_id,
    COUNT(*) AS event_count,
    MIN(event_time) AS session_start,
    MAX(event_time) AS session_end,
    ROUND(EXTRACT(EPOCH FROM (MAX(event_time) - MIN(event_time))) / 60, 1) AS session_duration_min,
    LIST(event_type) AS events
FROM session_ids
GROUP BY user_id, session_id
ORDER BY user_id, session_id;
运行结果:
┌─────────┬────────────┬─────────────┬─────────────────────┬─────────────────────┬──────────────────────┬─────────────────────────────────────────────────────────┐
│ user_id │ session_id │ event_count │    session_start    │     session_end     │ session_duration_min │                         events                          │
├─────────┼────────────┼─────────────┼─────────────────────┼─────────────────────┼──────────────────────┼─────────────────────────────────────────────────────────┤
│       1 │          1 │           5 │ 2026-09-10 08:00:00 │ 2026-09-10 09:05:00 │                 65.0 │ [page_view, page_view, add_to_cart, checkout, purchase] │
│       2 │          1 │           2 │ 2026-09-10 10:00:00 │ 2026-09-10 10:20:00 │                 20.0 │ [page_view, page_view]                                  │
│       2 │          2 │           2 │ 2026-09-10 11:00:00 │ 2026-09-10 11:05:00 │                  5.0 │ [add_to_cart, purchase]                                 │
└─────────┴────────────┴─────────────┴─────────────────────┴─────────────────────┴──────────────────────┴─────────────────────────────────────────────────────────┘
user_id=2 在 10:20 之后有超过 30 分钟的空白,被正确识别为两个独立会话。
4. 综合实战:完整异常检测管道
将上述技巧整合到一个端到端的检测管道中:
WITH sensor_data(ts, value) AS (
    SELECT * FROM (VALUES
        (TIMESTAMP '2026-09-10 08:05:00', 45.2),
        (TIMESTAMP '2026-09-10 08:20:00', 43.7),
        (TIMESTAMP '2026-09-10 09:10:00', 46.7),
        (TIMESTAMP '2026-09-10 10:10:00', 120.5),
        (TIMESTAMP '2026-09-10 10:15:00', 51.2)
    ) AS t
),
-- Step 1: 补全缺失时间槽
full_series AS (
    SELECT generate_series AS ts
    FROM generate_series(
        TIMESTAMP '2026-09-10 08:00:00',
        TIMESTAMP '2026-09-10 10:30:00',
        INTERVAL '30' MINUTE
    )
),
-- Step 2: 前向填充缺失值
merged AS (
    SELECT
        s.ts,
        LAST_VALUE(d.value IGNORE NULLS) OVER (
            ORDER BY s.ts ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
        ) AS filled_value
    FROM full_series s
    LEFT JOIN sensor_data d ON s.ts = d.ts
),
-- Step 3: 滑动窗口异常检测
hourly AS (
    SELECT
        date_trunc('hour', ts) AS hour_bucket,
        ROUND(AVG(filled_value), 2) AS avg_val
    FROM merged
    GROUP BY hour_bucket
)
SELECT
    hour_bucket,
    avg_val,
    ROUND(AVG(avg_val) OVER (
        ORDER BY hour_bucket
        ROWS BETWEEN 1 PRECEDING AND 1 PRECEDING
    ), 2) AS prev_hour_avg,
    CASE
        WHEN avg_val > AVG(avg_val) OVER (
            ORDER BY hour_bucket
            ROWS BETWEEN 1 PRECEDING AND 1 PRECEDING
        ) * 1.5 THEN '🔴 ANOMALY'
        ELSE '🟢 NORMAL'
    END AS alert
FROM hourly
ORDER BY hour_bucket;
这个管道依次完成了:时间补全 → 前向填充 → 小时聚合 → 滑动窗口对比 → 异常标记,覆盖了从原始数据到告警输出的完整流程。
5. 三种方法对比
| 方法 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| 全局统计阈值 | 离线批处理、历史数据回溯 | 实现简单,概念直观 | 异常值多时会稀释阈值 |
| 滑动窗口对比 | 实时监控、告警系统 | 对长期趋势不敏感,响应快 | 需要足够的历史窗口 |
| 事件间隔分析 | 用户行为、设备心跳监控 | 发现逻辑异常而非数值异常 | 需要合理设定间隔阈值 |
总结
DuckDB 不需要额外的 ML 库就能完成大多数异常检测场景:
- 统计阈值 —
AVG ± 2*STDDEV,适合离线分析 - 滑动窗口 —
LAG+ 窗口函数,适合实时监控 - 间隔分析 —
LAG+EXTRACT(EPOCH FROM ...),适合行为异常 - 会话断裂 — 累积和 + 分组,经典的 gap-and-island 问题
将 generate_series 与 LAST_VALUE(... IGNORE NULLS) 结合,还能在前向填充缺失数据的同时完成异常检测,形成完整的监控流水线。
💡 试试看! 将
sensor_data替换为你自己的业务数据(服务器日志、交易流水、传感器读数),调整1.5的倍数阈值和30分钟的间隔阈值,即可快速搭建一套异常检测系统。
更多 DuckDB 实战技巧,请关注 DuckDB Lab(duckdblab.org)
本文信息
| 项目 | 内容 |
|---|---|
| DuckDB 版本 | v1.5.2 (Variegata) |
| 最后验证 | 2026-09-16 |
| 测试环境 | Linux / x86_64 / DuckDB CLI |
| 官方文档 | DuckDB Documentation |
| GitHub | pengzz9527/duckdb-blog |
如发现错误,欢迎通过 GitHub Issue 或邮件 [email protected] 反馈。